Không có thông báo nào

NVIDIA dùng AI để tối ưu chuỗi cung ứng chip với Palantir Foundry và cuOpt

NVIDIA đang ứng dụng trí tuệ nhân tạo và các thuật toán tối ưu hóa để giải quyết một trong những bài toán phức tạp nhất phía sau sự bùng nổ của hạ tầng AI: làm thế nào để phân bổ linh kiện, năng lực sản xuất và nguồn cung trên toàn bộ chuỗi cung ứng một cách hiệu quả nhất. Hệ thống này kết hợp Palantir Foundry, nền tảng quản lý dữ liệu và vận hành doanh nghiệp, với NVIDIA cuOpt, công cụ tối ưu hóa được tăng tốc bằng GPU. Bên cạnh đó, NVIDIA còn sử dụng mô hình ngôn ngữ Nemotron để hỗ trợ xử lý những thông tin mà các mô hình tối ưu hóa truyền thống khó đưa trực tiếp vào bài toán.

Bài toán chuỗi cung ứng ngày càng phức tạp

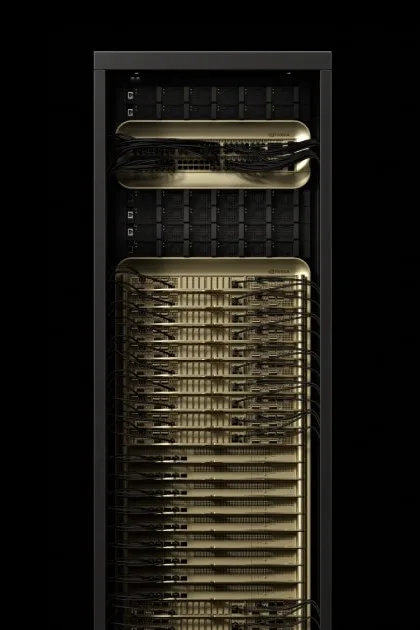
Việc sản xuất một hệ thống AI hiện đại không đơn giản là tạo ra một GPU rồi lắp vào máy chủ. Một hệ thống như NVIDIA Grace Blackwell NVL72 cần rất nhiều thành phần khác nhau, được cung cấp bởi mạng lưới đối tác và nhà sản xuất trên toàn cầu. Một rack NVL72 bao gồm 18 compute tray. Mỗi tray sử dụng hai Grace CPU, bốn Blackwell GPU cùng 32 package bộ nhớ HBM3e. Do đó, chỉ một linh kiện bị thiếu hoặc giao chậm cũng có thể ảnh hưởng tới tiến độ hoàn thiện cả hệ thống. NVIDIA đặc biệt quan tâm đến thời gian từ lúc vật liệu xuất hiện trong chuỗi cung ứng cho tới khi hệ thống AI thực sự có thể hoạt động. Hai chỉ số được đề cập là Time-to-Rack và Time-to-Token. Time-to-Rack tập trung vào thời gian để hoàn thành một rack, trong khi Time-to-Token kéo dài tới thời điểm hệ thống đã có đầy đủ điện, làm mát, mạng và phần mềm để bắt đầu thực hiện workload AI. Điều này cho thấy mục tiêu không chỉ là sản xuất GPU nhanh hơn, mà còn phải rút ngắn toàn bộ khoảng thời gian từ chip đến một hệ thống AI có thể tạo ra kết quả thực tế.

Nvidia NVL72

Palantir Foundry tạo ra "bản đồ" của chuỗi cung ứng

Để quản lý lượng dữ liệu khổng lồ này, NVIDIA xây dựng Digital Supply Chain Intelligence trên nền tảng Palantir Foundry. Một thành phần quan trọng của Foundry là Ontology. Thay vì xem dữ liệu về nhà máy, linh kiện, nhà cung cấp, hàng tồn kho và đơn hàng như những tập dữ liệu riêng biệt, Ontology mô hình hóa chúng thành các đối tượng có quan hệ với nhau. Ví dụ, hệ thống có thể liên kết một GPU với nhà cung cấp, nhà máy, lượng tồn kho, đơn hàng và năng lực sản xuất tương ứng. Nhờ đó, các thuật toán tối ưu có thể nhìn thấy mối quan hệ giữa những yếu tố khác nhau trong chuỗi cung ứng thay vì chỉ xử lý từng bảng dữ liệu độc lập.

Palantir Foundry Nvidia

cuOpt đảm nhiệm phần tối ưu hóa

Sau khi dữ liệu được tổ chức trong Foundry, NVIDIA sử dụng cuOpt để giải bài toán phân bổ. CuOpt có thể xử lý các bài toán tối ưu hóa phức tạp, trong đó có Mixed-Integer Linear Programming (MILP). Hệ thống phải tìm cách phân bổ nguồn lực sao cho thời gian sở hữu vật liệu và thời gian hoàn thành sản phẩm được giảm xuống, đồng thời vẫn phải tuân thủ các giới hạn về năng lực sản xuất. Các kế hoạch phân bổ có thể được tính toán lại hàng tuần với tầm nhìn kéo dài khoảng hai quý. Điều này cho phép NVIDIA liên tục điều chỉnh kế hoạch khi nguồn cung, nhu cầu hoặc năng lực của các nhà máy thay đổi. Quan trọng hơn, hệ thống không chỉ tạo ra lịch phân bổ. Nó còn giúp xác định những điểm nghẽn đang giới hạn sản lượng. Ví dụ, một nhà máy có thể còn dư công suất nhưng lại thiếu HBM, trong khi một cơ sở khác có đủ HBM nhưng thiếu GPU hoặc năng lực lắp ráp. Việc xác định chính xác nút thắt giúp NVIDIA biết nên điều chỉnh nguồn lực ở đâu.

cuOpt

AI xử lý những yếu tố mà thuật toán truyền thống khó hiểu

Tối ưu hóa toán học vẫn chưa giải quyết được toàn bộ vấn đề. Các planner của NVIDIA phải đối mặt với nhiều thông tin phi cấu trúc như email của nhà cung cấp, nội dung trao đổi trong các cuộc họp, tình hình thời tiết hoặc những sự kiện địa chính trị có thể ảnh hưởng đến sản xuất và vận chuyển. Những thông tin này rất khó đưa trực tiếp vào một mô hình MILP. Đây là nơi Nemotron 3.5 Lightning được sử dụng. Mô hình thuộc kiến trúc Mixture-of-Experts (MoE), có tổng cộng khoảng 30 tỷ tham số nhưng chỉ kích hoạt khoảng 3 tỷ tham số trong mỗi lần xử lý. NVIDIA tiến hành post-training mô hình bằng dữ liệu vận hành lịch sử nhằm giúp AI đưa ra các khuyến nghị phù hợp với những tình huống thực tế trong chuỗi cung ứng.

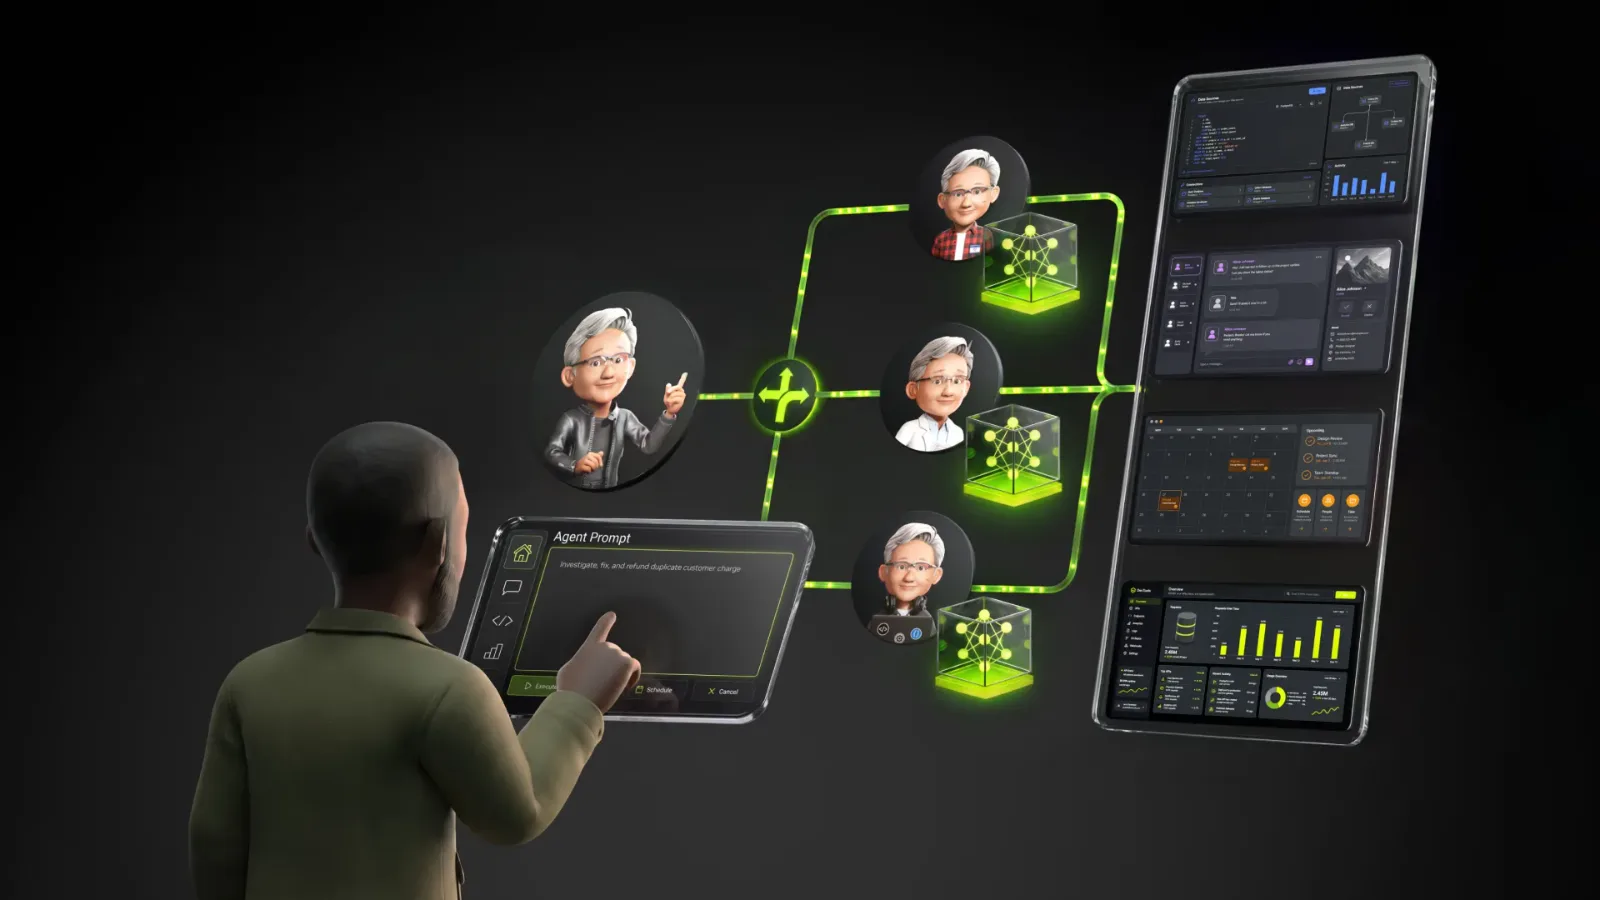
Nemotron 3.5 Lightning

Nhập nội dung tùy ý tại đây.

Kết quả sau khi huấn luyện

Theo số liệu NVIDIA được AI News dẫn lại, Nemotron 3.5 Lightning sau khi post-training đạt 86,7% decision accuracy trên dữ liệu phân bổ lịch sử. Trong cùng phép đánh giá, Nemotron 3 Ultra đạt 55,5%, còn phiên bản Lightning chưa được fine-tune chỉ đạt 17,5%. Mô hình sau huấn luyện cũng đạt 58,6% balanced accuracy và 57,5% macro-F1. Một điểm đáng chú ý là NVIDIA cho biết quá trình fine-tuning có thể hoàn thành trên chỉ hai GPU NVIDIA B200 trong vài phút.

Tuy nhiên, dự báo những rủi ro sản xuất xảy ra ở xa trong tương lai vẫn là một thách thức. Chuỗi cung ứng có quá nhiều biến số và một số sự kiện khó dự đoán trước.

NVIDIA sử dụng LoRA và dữ liệu tổng hợp

Pipeline huấn luyện của NVIDIA sử dụng nhiều công cụ trong hệ sinh thái NeMo.

NeMo Anonymizer giúp loại bỏ hoặc che giấu những dữ liệu vận hành nhạy cảm.

NeMo Data Designer được sử dụng để xây dựng và cân bằng dữ liệu huấn luyện, trong đó có những tình huống gián đoạn chuỗi cung ứng được tạo ra dưới dạng dữ liệu tổng hợp.

Sau đó, NeMo AutoModel hỗ trợ quá trình fine-tuning bằng phương pháp LoRA (Low-Rank Adaptation). Mô hình sau khi huấn luyện có thể được đưa vào quy trình vận hành thông qua hệ thống của Palantir, đồng thời duy trì khả năng theo dõi nguồn gốc dữ liệu và quá trình phát triển mô hình.

Hướng tới một vòng lặp AI khép kín

NVIDIA đang hướng hệ thống này tới một mô hình hoạt động liên tục. Các quyết định của planner, những thay đổi trong kế hoạch, các lần con người can thiệp và kết quả thực tế sẽ được ghi nhận trở lại trong Palantir Ontology. Dữ liệu này có thể trở thành cơ sở để xây dựng các preference pairs phục vụ quá trình Reinforcement Learning.

Về lâu dài, AI không chỉ đưa ra một phương án phân bổ dựa trên dữ liệu lịch sử mà còn có thể học từ việc những quyết định trước đó đã mang lại kết quả như thế nào.

Tuy vậy, NVIDIA cho biết mô hình production được tách khỏi việc tự động retraining từ dữ liệu live không được giám sát. Điều này giúp hạn chế nguy cơ hệ thống tự học từ những dữ liệu vận hành chưa được kiểm chứng.

Vera Rubin sẽ khiến bài toán lớn hơn

Bài toán này còn trở nên phức tạp hơn khi NVIDIA chuyển sang thế hệ kiến trúc tiếp theo. Theo thông tin được AI News đưa ra, mạng lưới chuỗi cung ứng phục vụ Vera Rubin dự kiến có quy mô khoảng gấp đôi mạng lưới hiện đang hỗ trợ Grace Blackwell. Điều đó đồng nghĩa với việc số lượng linh kiện, nhà cung cấp, cơ sở sản xuất và các mối quan hệ cần quản lý sẽ tiếp tục tăng mạnh.

Trong bối cảnh đó, việc sử dụng con người để lập kế hoạch thủ công ngày càng khó đáp ứng yêu cầu. NVIDIA đang xây dựng một cách tiếp cận kết hợp nhiều lớp công nghệ: Palantir Foundry để tổ chức dữ liệu và mô hình hóa chuỗi cung ứng, cuOpt để giải các bài toán tối ưu hóa, còn Nemotron đảm nhiệm việc xử lý và hỗ trợ ra quyết định từ những thông tin phức tạp hơn.

Đây là một ví dụ đáng chú ý về cách AI đang được đưa ra khỏi phạm vi chatbot và tạo sinh nội dung để tham gia trực tiếp vào các quyết định vận hành quy mô lớn.

Với NVIDIA, mục tiêu cuối cùng không chỉ là đưa thêm GPU vào chuỗi cung ứng, mà là giảm thời gian từ lúc chip được sản xuất cho tới khi một hệ thống AI hoàn chỉnh có thể thực sự tạo ra token đầu tiên.

Nguồn: artificialintelligence-news
Cộng đồng: