Không có thông báo nào

NVIDIA Vera CPU: 88 nhân Olympus monolithic, băng thông 3.4 TB/s thách thức kỷ nguyên chiplet cho Agentic AI

NVIDIA ra mắt Vera CPU với 88 nhân Olympus trên die monolithic, đạt băng thông 3.4 TB/s và hiệu năng single-thread vượt trội. Thiết kế này tối ưu hóa chu trình suy luận của AI Agent, giảm thiểu độ trễ so với kiến trúc chiplet truyền thống.

NVIDIA Vera CPU tái định nghĩa kiến trúc CPU cho kỷ nguyên Agentic AI

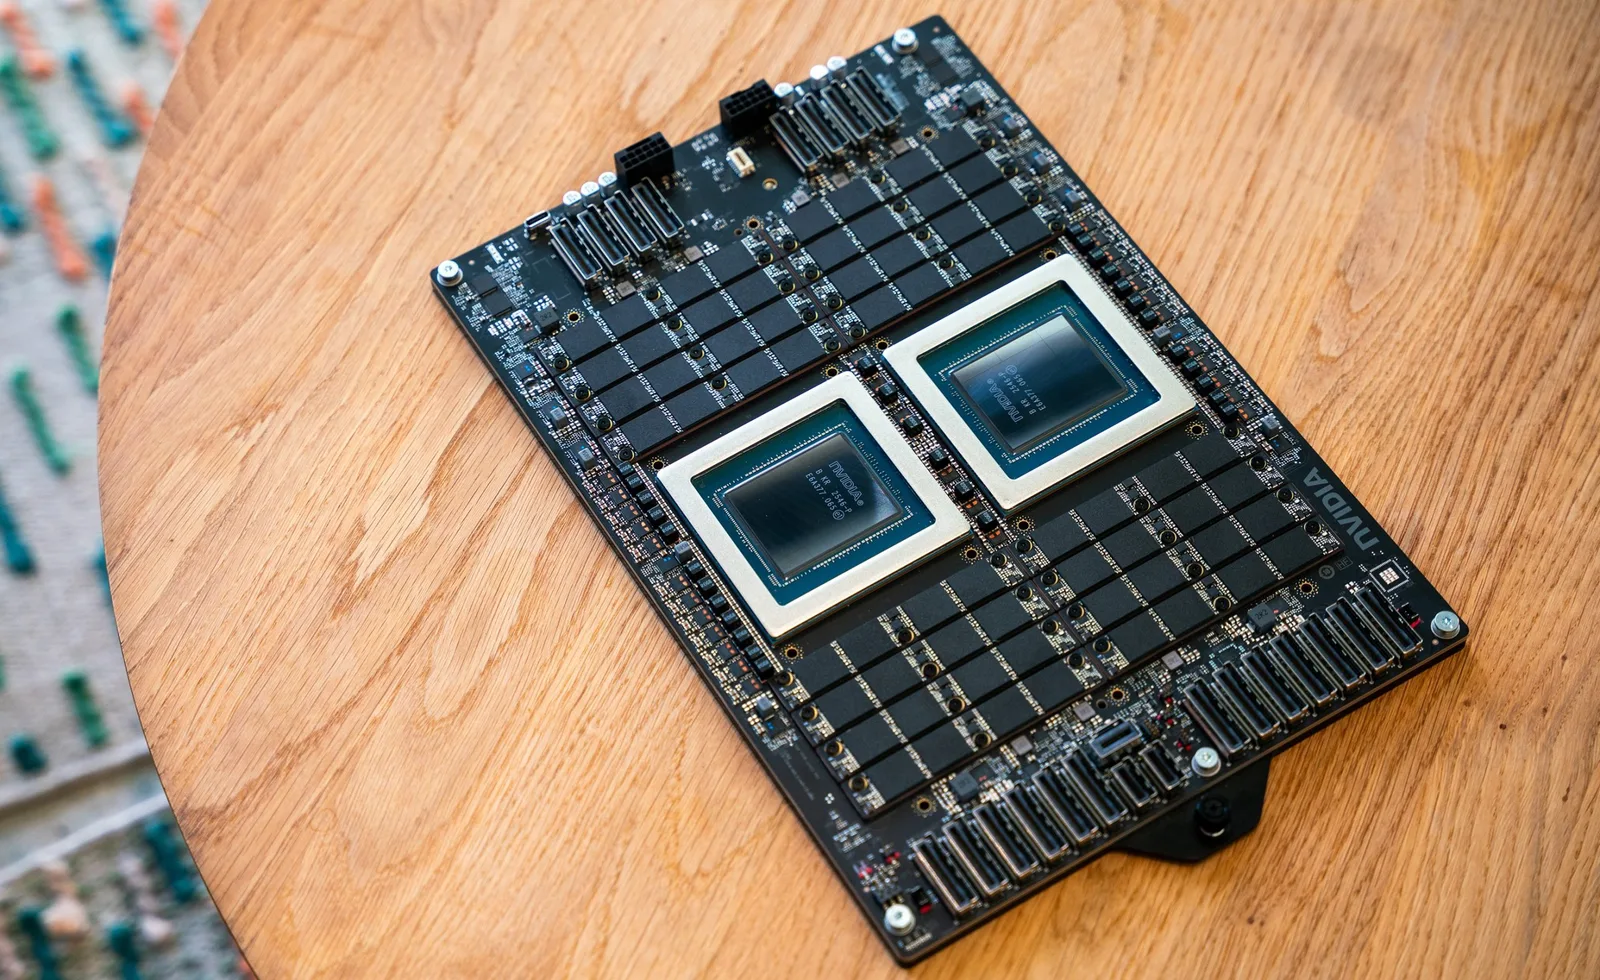
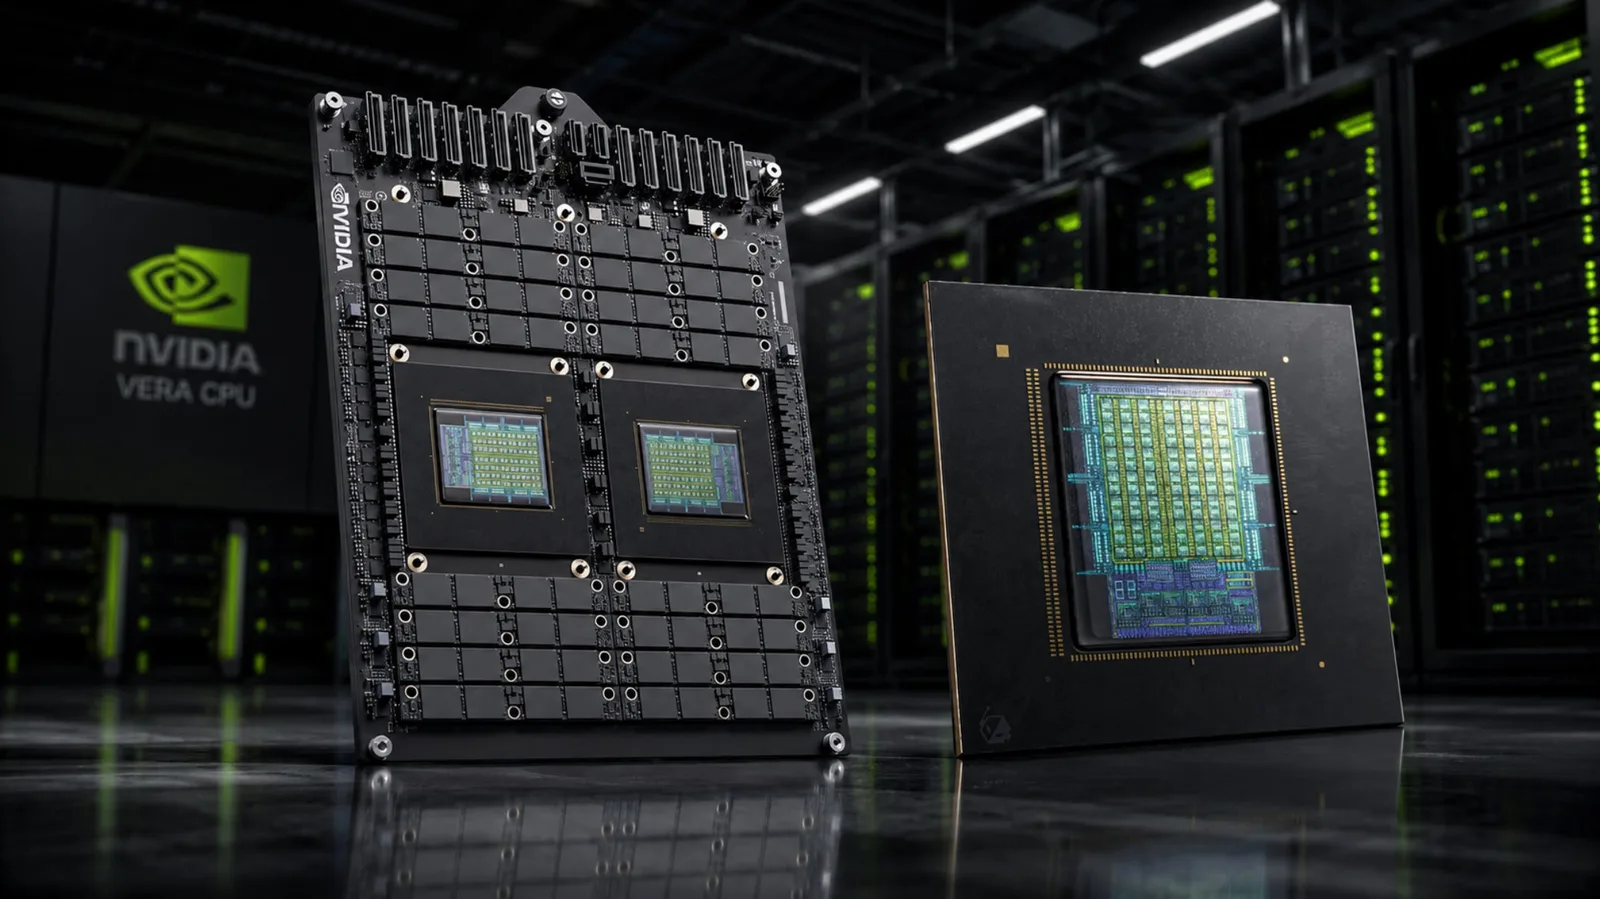
Trong bối cảnh các hệ thống AI chuyển dịch từ mô hình chatbot đơn giản sang các AI Agent tự chủ, NVIDIA đã công bố Vera CPU – bộ vi xử lý đầu tiên được thiết kế chuyên biệt để giải quyết các thách thức về độ trễ và hiệu năng single-thread trong các tác vụ suy luận phức tạp. Theo dữ liệu từ NVIDIA, Vera CPU tích hợp 88 nhân Olympus tùy chỉnh trên một die tính toán monolithic (đơn khối), đi kèm hệ thống bộ nhớ LPDDR5X tùy chỉnh. Kiến trúc này được đánh giá là bước ngoặt nhằm phá vỡ sự đánh đổi truyền thống giữa số lượng nhân và tốc độ xử lý của từng nhân. Điểm khác biệt cốt lõi của Vera nằm ở việc loại bỏ các rào cản giao tiếp giữa các chiplet (chiplet tax). Thay vì chia nhỏ bộ xử lý thành nhiều die nhỏ kết nối qua I/O, Vera đặt tất cả 88 nhân trên cùng một die duy nhất. Điều này cho phép các nhân giao tiếp với nhau mà không phải vượt qua các ranh giới I/O, từ đó loại bỏ độ trễ bổ sung. NVIDIA tuyên bố rằng thiết kế này mang lại băng thông bisection (băng thông cắt đôi) lên đến 3.4 TB/s, gấp 3 lần so với các chip x86 hàng đầu hiện nay, đảm bảo dữ liệu được luân chuyển nhanh chóng giữa các nhân và bộ nhớ. Sự ra đời của Vera CPU đánh dấu sự thay đổi trong triết lý thiết kế phần cứng của NVIDIA. Nếu như thế hệ trước (Grace) tập trung vào việc làm 'host node' cho GPU, thì Vera được định vị là một nền tảng độc lập mạnh mẽ cho các tác vụ tuần tự (sequential tasks) như thực thi mã, gọi công cụ (tool calls) và xử lý sandbox. Mục tiêu cuối cùng là giữ cho các tài sản GPU đắt tiền luôn ở trạng thái hoạt động tối đa bằng cách đảm bảo CPU hoàn thành các bước chuẩn bị và xử lý hậu kỳ một cách tức thời, không để GPU phải chờ đợi.

NVIDIA Vera CPU với kiến trúc monolithic 88 nhân Olympus

Tại sao kiến trúc chiplet trở thành điểm nghẽn cho AI Agent?

Theo chia sẻ từ đội ngũ phát triển Vera của NVIDIA, trong suốt thập kỷ qua, ngành công nghiệp CPU dữ liệu trung tâm đã ưu tiên tối đa hóa số lượng nhân (core count) để tăng thông lượng (throughput) và giảm chi phí trên mỗi đơn vị máy chủ. Để đạt được mật độ nhân cao, các nhà sản xuất x86 đã chuyển sang kiến trúc chiplet, nơi bộ xử lý được chia thành nhiều die nhỏ hơn. Tuy nhiên, NVIDIA lập luận rằng cách tiếp cận này đã hy sinh hiệu năng single-thread và IPC (Instructions Per Cycle) vì không còn đủ không gian vật lý trên die để tối ưu hóa tốc độ của từng nhân riêng lẻ. Đối với các tác vụ Agentic AI, điều này tạo ra một vấn đề nghiêm trọng. AI Agent hoạt động theo các vòng lặp suy luận liên tục: chúng cần thực thi một bước tuần tự trên CPU, sau đó chuyển sang GPU để suy luận tiếp, rồi quay lại CPU cho bước tiếp theo. Nếu CPU quá chậm trong việc xử lý các bước tuần tự này do độ trễ cao từ kiến trúc chiplet, GPU sẽ bị lãng phí thời gian chờ đợi. NVIDIA gọi đây là 'chiplet tax' – một loại thuế phí hiệu năng vô hình mà các hệ thống đa chiplet phải gánh chịu khi xử lý các tác vụ nhạy cảm với độ trễ. NVIDIA nhấn mạnh rằng trong các phiên làm việc của AI Agent, phần lớn thời gian thực (wall-clock time) bị chi phối bởi chuỗi các bước tuần tự (sequential chain) chứ không phải các tác vụ song song. Dữ liệu từ 163.594 phiên Agentic AI cho thấy hơn 97% các phiên có hồ sơ quỹ đạo (trajectory profiles) độc đáo, điều này khiến việc tối ưu hóa phần cứng dựa trên các kịch bản song song cố định trở nên kém hiệu quả. Do đó, một CPU cần có khả năng duy trì hiệu năng single-thread cao ngay cả khi toàn bộ các nhân đang hoạt động, thay vì chỉ nhanh khi chạy một nhân duy nhất.
Sơ đồ minh họa các nhánh xử lý của AI Agent và điểm nghẽn độ trễ

Hiệu năng thực chiến: Vera CPU vượt trội 1.5x so với đối thủ x86 trong tác vụ Agentic

NVIDIA đã công bố các kết quả ước tính từ bộ benchmark SPEC CPU 2026, cho thấy Vera CPU đạt hiệu năng per-core (trên mỗi nhân) cao hơn 1.5 lần so với AMD Venice (thế hệ EPYC tiếp theo) trong bốn tác vụ Agentic điển hình, bao gồm biên dịch mã (compiler), phân tích tĩnh (static analysis) và các benchmark Python. Các số liệu này được hỗ trợ bởi dữ liệu thực tế từ các đối tác như Perplexity, nơi Vera CPU ghi nhận mức tăng hiệu năng 1.5x trong các tác vụ coding agent và 1.9x khi chạy các sandbox song song. Trong các tác vụ phân tích cơ sở dữ liệu, lợi thế của kiến trúc monolithic và băng thông bộ nhớ cao của Vera thể hiện rõ rệt. Starburst, một công ty về cơ sở dữ liệu liên kết, ghi nhận mức tăng hiệu năng 3x trong các truy vấn SQL quy mô lớn, trong khi Redpanda báo cáo mức giảm độ trễ 6x trong phân tích thời gian thực. Những con số này phản ánh khả năng của Vera trong việc cung cấp băng thông bộ nhớ 1.2 TB/s (qua LPDDR5X) cho mỗi nhân, đảm bảo dữ liệu luôn sẵn sàng mà không gây nghẽn cổ chai. Tuy nhiên, cần lưu ý rằng các benchmark này được thực hiện trong các kịch bản được phê duyệt bởi nhà sản xuất và tập trung vào các tác vụ cụ thể của Agentic AI. Trong khi đó, các đối thủ cạnh tranh như AMD và Intel vẫn duy trì chiến lược tối ưu hóa thông lượng tổng thể (throughput) cho các tác vụ đa luồng truyền thống. NVIDIA định vị Vera không phải là một 'quái vật song song' (parallel monster) mà là một 'CPU single-thread tối đa ở quy mô lớn' (max single-threaded CPU at scale), nhắm vào phân khúc thị trường nơi độ trễ là yếu tố quyết định hiệu quả kinh tế của hệ thống AI.

Biểu đồ so sánh hiệu năng per-core của NVIDIA Vera CPU và AMD Venice

Hệ sinh thái phần mềm và tương lai của nền tảng Vera-Rigel

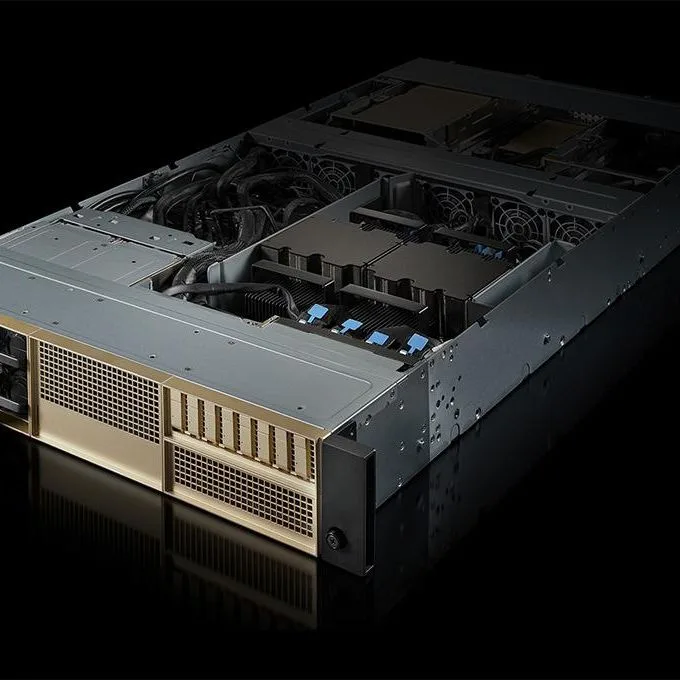
NVIDIA không chỉ dừng lại ở Vera CPU mà còn hé lộ thế hệ nhân tiếp theo mang tên Rigel (dựa trên kiến trúc Arm v9.2), dự kiến sẽ được tích hợp vào nền tảng Rosa. Theo NVIDIA, nhân Rigel sẽ cung cấp hiệu năng per-core cao hơn Olympus trong cùng một diện tích silicon nhờ vào cơ chế phân phối lệnh (instruction delivery) tốt hơn, bộ nhớ đệm L2 lớn hơn và khả năng xử lý bộ nhớ hiệu quả hơn. Điều này cho thấy NVIDIA đang xây dựng một lộ trình dài hạn để duy trì lợi thế cạnh tranh trong phân khúc CPU dành cho AI. Về mặt hệ sinh thái, Vera CPU được thiết kế để tích hợp liền mạch với các GPU NVIDIA thông qua công nghệ NVLink và các giao thức kết nối tốc độ cao. Điều này cho phép xây dựng các 'AI Factories' (nhà máy AI) nơi CPU và GPU phối hợp nhịp nhàng, tối ưu hóa việc chuyển đổi công suất và vốn đầu tư thành các tác vụ Agent hoàn thành. NVIDIA nhấn mạnh rằng một đội máy chủ (fleet) hiệu quả cần một điểm thiết kế CPU cân bằng (balanced design point) duy nhất, thay vì phải chia nhỏ đội máy chủ thành nhiều loại CPU chuyên biệt khác nhau. Sự xuất hiện của Vera CPU cũng đặt ra câu hỏi về tương lai của kiến trúc chiplet trong trung tâm dữ liệu. Trong khi chiplet vẫn là giải pháp tối ưu cho việc tăng mật độ nhân và giảm chi phí sản xuất, NVIDIA chứng minh rằng trong các tác vụ AI nhạy cảm với độ trễ, kiến trúc monolithic với băng thông nội bộ cực cao có thể là lựa chọn vượt trội. Cuộc cạnh tranh giữa các hãng phần cứng đang chuyển dịch từ cuộc đua số lượng nhân sang cuộc đua về hiệu năng đơn luồng và độ trễ, mở ra một chương mới cho thiết kế CPU trong kỷ nguyên trí tuệ nhân tạo tự chủ.

NVIDIA Vera CPU trong hệ sinh thái AI Factory
Cộng đồng: