Không có thông báo nào

AMD và Intel hợp tác chuẩn hóa x86 AI: Tích hợp ZenDNN vào oneDNN và ra mắt bộ mở rộng ACE

AMD và Intel chính thức hợp tác chuẩn hóa phần mềm AI trên CPU x86 thông qua oneDNN và bộ mở rộng ACE. Động thái này giúp giảm phân mảnh hệ sinh thái, tối ưu hiệu năng PyTorch và hỗ trợ các định dạng dữ liệu AI mới như FP8, BF16.

AMD và Intel hợp tác chuẩn hóa phần mềm AI trên nền tảng x86

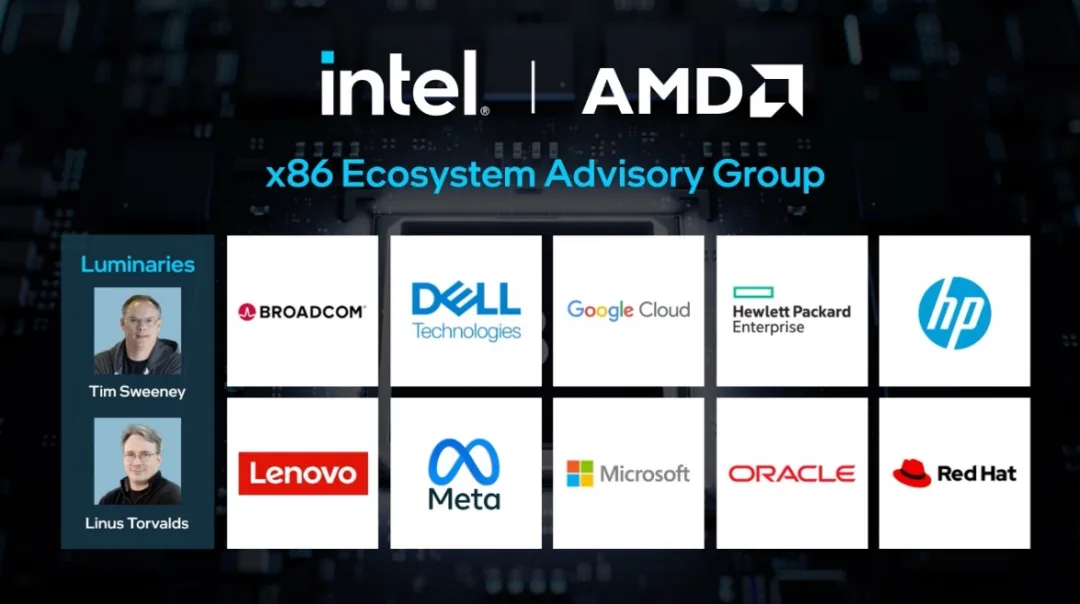
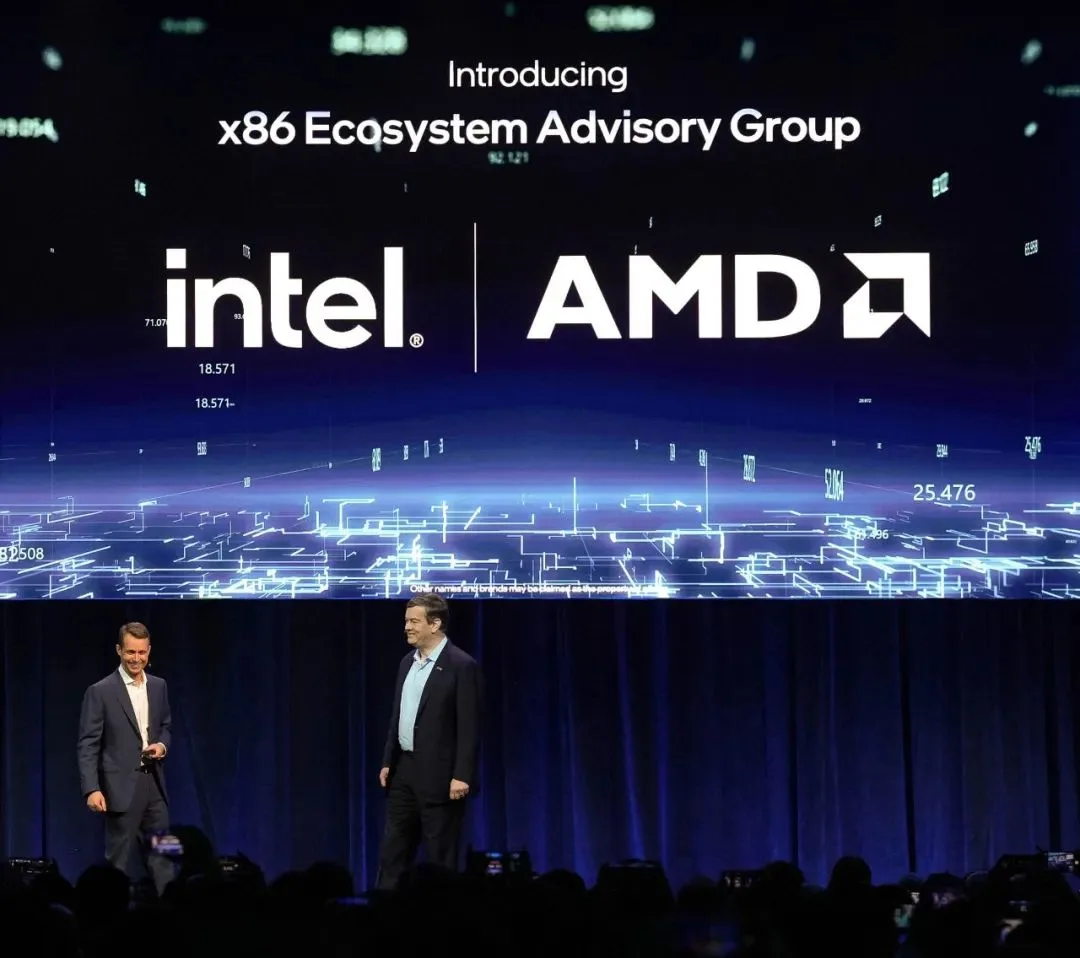
Trong một động thái hiếm thấy giữa hai đối thủ lớn nhất của ngành phần cứng, AMD và Intel đã chính thức công bố kế hoạch hợp tác nhằm đơn giản hóa quy trình phát triển AI trên các bộ xử lý x86. Theo thông báo chính thức từ Intel, cả hai hãng sẽ kết hợp nỗ lực tối ưu hóa CPU cho framework PyTorch vào thư viện mã nguồn mở oneDNN (oneAPI Data Neural Network). MộtDNN hiện được quản lý bởi Unified Acceleration Foundation (UXL), tổ chức mà AMD đã gia nhập với tư cách thành viên Ban chỉ đạo (Steering Member) để thúc đẩy các sáng kiến mở. Sự hợp tác này được thúc đẩy bởi khuyến nghị từ Nhóm Tư vấn Hệ sinh thái x86 (x86 Ecosystem Advisory Group - EAG), một sáng kiến chung được thành lập từ tháng 10/2024. Mục tiêu cốt lõi là loại bỏ sự phân mảnh trong hệ sinh thái AI x86, nơi trước đây các nhà phát triển phải duy trì hai đường dẫn phần mềm riêng biệt cho AMD và Intel. Bằng cách thống nhất oneDNN làm thư viện mặc định cho gia tốc x86 trong PyTorch, các nhà phát triển sẽ có một điểm truy cập duy nhất để tối ưu hóa hiệu năng, giảm thiểu chi phí bảo trì và tăng tốc độ triển khai ứng dụng AI trên các máy chủ, workstation và PC. Jeff McVeigh, Phó Chủ tịch và Giám đốc Điều hành các Chương trình Chiến lược Trung tâm Dữ liệu của Intel, nhấn mạnh rằng các nhà phát triển không nên phải lo lắng về việc lựa chọn đường dẫn phần mềm riêng biệt để khai thác tối đa hiệu năng CPU x86. Sự hợp tác này không chỉ mang lại sự nhất quán cho các bộ xử lý hiện tại mà còn mở đường cho việc tích hợp các tính năng tương lai, bao gồm cả bộ mở rộng AI Compute Extensions (ACE), trực tiếp vào framework PyTorch.

AMD và Intel hợp tác chuẩn hóa phần mềm AI trên nền tảng x86 thông qua oneDNN

Tích hợp ZenDNN vào oneDNN: Bước tiến trong hệ sinh thái phần mềm mở

Một điểm nhấn kỹ thuật quan trọng trong thỏa thuận này là việc AMD tích hợp các tối ưu hóa ZenDNN của mình vào oneDNN. ZenDNN là bộ thư viện tối ưu hóa riêng của AMD dành cho các tác vụ học sâu, vốn trước đây chỉ hoạt động hiệu quả trên các bộ xử lý của hãng. Việc đưa ZenDNN vào oneDNN có nghĩa là các tối ưu hóa này sẽ trở nên khả dụng rộng rãi hơn cho cả hệ sinh thái x86, không chỉ giới hạn trong các ứng dụng được biên dịch cụ thể cho AMD. Robert Hormuth, Phó Chủ tịch cấp cao phụ trách Kiến trúc và Chiến lược tại AMD, cho biết công ty đang thúc đẩy một hệ sinh thái phần mềm mở, mang lại cho nhà phát triển nhiều lựa chọn hơn và giúp việc xây dựng các ứng dụng AI hiệu suất cao trở nên dễ dàng hơn. Sự tham gia của AMD vào UXL Foundation với vai trò thành viên Ban chỉ đạo khẳng định cam kết của hãng trong việc thúc đẩy hợp tác mở và tiêu chuẩn hóa, thay vì cạnh tranh dựa trên các silo phần mềm độc quyền. Stephen Watt, Phó Chủ tịch Văn phòng CTO và Kỹ sư danh dự tại Red Hat (đồng thời là đại sứ cộng đồng PyTorch), đánh giá cao bước đi này. Ông nhận định rằng sự đổi mới mã nguồn mở phát triển mạnh mẽ nhất khi trải nghiệm của nhà phát triển và vận hành được liền mạch và thống nhất. Việc AMD và Intel cùng nhau chuẩn hóa các tối ưu hóa CPU x86 thông qua oneDNN trong PyTorch là một bước tiến lớn trong việc loại bỏ sự phân mảnh hệ sinh thái, giúp việc xây dựng, tối ưu và triển khai các workload AI trở nên nhất quán trên các kiến trúc x86.

AMD tích hợp ZenDNN vào oneDNN và gia nhập Unified Acceleration Foundation

Giới thiệu ACE: Bộ mở rộng chỉ thị thế hệ mới cho phép nhân ma trận AI

Ngoài việc thống nhất phần mềm, AMD và Intel còn đang hợp tác phát triển AI Compute Extensions (ACE), một kiến trúc tập lệnh (ISA) thế hệ mới dành cho x86. Theo tài liệu kỹ thuật từ AMD và phân tích từ TechSpot, ACE được thiết kế chuyên biệt để gia tốc phép nhân ma trận (matrix multiplication) - phép toán cốt lõi trong cả quá trình huấn luyện lẫn suy luận (inference) của các mô hình AI. Khác với các lệnh AVX truyền thống vốn không được thiết kế riêng cho các workload nặng về ma trận, ACE cung cấp phần cứng chuyên dụng cho các thao tác này. Về mặt kỹ thuật, ACE giữ nguyên cấu trúc thanh ghi AVX10 hiện có nhưng bổ sung phần cứng chuyên dụng cho phép toán ma trận. Điều này giúp tránh việc ép buộc nhà phát triển phải thay đổi hoàn toàn định dạng dữ liệu hoặc mô hình lập trình. Các lệnh mở rộng vẫn sử dụng đầu vào 512-bit, cho phép chúng tích hợp vào các luồng phần mềm và phần cứng hiện tại với ít thay đổi nhất. Theo TechSpot, với cùng một tập vector đầu vào, ACE có thể thực hiện nhiều thao tác hơn AVX10 lên đến 16 lần, mặc dù hiệu năng thực tế phụ thuộc vào nhiều yếu tố khác nhau. ACE hỗ trợ một loạt các kiểu dữ liệu được sử dụng phổ biến trong học máy, bao gồm INT8, INT32, FP8, FP16, FP32 và BF16. Đặc biệt, ACE bao gồm hỗ trợ bản địa cho các định dạng block-scaled của Open Compute Project (OCP) MX, một tính năng không có trong AVX10. Sự linh hoạt này phản ánh sự đa dạng hóa trong yêu cầu của các mô hình AI, đặc biệt là trong lĩnh vực suy luận (inference) nơi hiệu quả năng lượng và băng thông bộ nhớ là yếu tố then chốt.
Kiến trúc ACE (AI Compute Extensions) tối ưu hóa phép nhân ma trận trên CPU x86

Lợi ích thực tiễn: Giảm phân mảnh và tối ưu hiệu năng cho AI PC và Server

Đối với các nhà phát triển và doanh nghiệp, lợi ích trực tiếp nhất của sự hợp tác này là sự nhất quán trong hiệu năng. Trước đây, việc tối ưu hóa một ứng dụng PyTorch cho CPU AMD và CPU Intel thường đòi hỏi các kỹ thuật và thư viện riêng biệt. Với oneDNN làm nền tảng chung, các workload AI sẽ có trải nghiệm hiệu năng nhất quán hơn trên các máy chủ x86, workstation và AI PC. Điều này đặc biệt quan trọng đối với các nhà cung cấp dịch vụ đám mây và các doanh nghiệp triển khai AI tại biên (edge), nơi việc di chuyển dữ liệu giữa CPU và GPU có thể tạo ra nút cổ chai về độ trễ và băng thông. ACE mang lại lợi thế về hiệu quả năng lượng đáng kể. Trong khi GPU rất mạnh mẽ nhưng cũng tiêu thụ nhiều năng lượng và yêu cầu di chuyển dữ liệu liên tục, việc xử lý các tác vụ AI trực tiếp trên CPU thông qua ACE có thể tiết kiệm hơn, đặc biệt là cho các trường hợp sử dụng biên hoặc ứng dụng đơn người dùng. TechSpot chỉ ra rằng việc giữ các tác vụ trên CPU tránh được chi phí overhead của việc truyền dữ liệu qua bus hệ thống, một lợi thế lớn cho các hệ thống có tài nguyên hạn chế hoặc yêu cầu phản hồi nhanh. Sự hợp tác này cũng củng cố vị thế của kiến trúc x86 trước áp lực từ các kiến trúc khác như Arm. Bằng cách chuẩn hóa các tính năng như FRED (Flexible Return and Event Delivery), AVX10, ChkTag (Memory Tagging) và ACE, AMD và Intel đang tạo ra một nền tảng x86 ổn định, dự đoán được và thân thiện với nhà phát triển. Điều này không chỉ giúp giảm chi phí phát triển phần mềm mà còn tăng cường bảo mật thông qua các tính năng như ChkTag, giúp phát hiện các lỗi bộ nhớ như buffer overflow và use-after-free.

Lợi ích của việc chuẩn hóa x86 AI: Giảm phân mảnh và tối ưu hiệu năng cho AI PC và Server

Tầm nhìn tương lai: Củng cố hệ sinh thái x86 và mở rộng đối tác ISV

Nhóm Tư vấn Hệ sinh thái x86 (EAG) đánh dấu một năm hoạt động với nhiều mốc kỹ thuật quan trọng. Bên cạnh ACE, EAG đã hoàn thiện FRED như một tính năng chuẩn, giới thiệu mô hình ngắt hiện đại hóa nhằm giảm độ trễ và cải thiện độ tin cậy của phần mềm hệ thống. AVX10 đã được thiết lập như bộ mở rộng tập lệnh vector và chung dụng thế hệ tiếp theo, tăng thông lượng và đảm bảo khả năng di chuyển giữa các CPU client, workstation và server. ChkTag, một quy cách gán thẻ bộ nhớ thống nhất, cũng đã được giới thiệu để chống lại các lỗ hổng bảo mật bộ nhớ lâu nay. ChkTag thêm các chỉ thị phần cứng để phát hiện vi phạm, giúp bảo vệ ứng dụng, hệ điều hành, hypervisor và firmware. Phần mềm được kích hoạt ChkTag vẫn tương thích với các bộ xử lý không có hỗ trợ phần cứng, đơn giản hóa việc triển khai và bổ sung cho các tính năng bảo mật hiện có như shadow stack và tính toán bí mật. Bước sang năm thứ hai, AMD và Intel cam kết tiếp tục mở rộng các đối tác ISV chiến lược mới, đánh giá các bộ mở rộng ISA mới mang lại lợi thế rõ ràng cho khách hàng và củng cố sự ổn định dài hạn của kiến trúc x86. Sự hợp tác này không nhằm thay thế GPU trong các môi trường huấn luyện quy mô lớn, mà tập trung vào việc mở rộng vai trò của CPU trong các workload AI nhỏ hơn, nhạy cảm với độ trễ và các hệ thống nơi GPU không khả dụng hoặc không hiệu quả về mặt chi phí. Đây là một bước đi chiến lược để giữ vững vị thế của x86 trong kỷ nguyên AI.

Tầm nhìn tương lai của hệ sinh thái x86 với các chuẩn ACE, FRED, AVX10 và ChkTag
Cộng đồng: