Không có thông báo nào

Siêu phẩm KV Cache: Supermicro hợp tác IBM, NVIDIA giảm 56x thời gian truy xuất ngữ cảnh

Supermicro, IBM và NVIDIA công bố giải pháp lưu trữ KV Cache dựa trên AMD EPYC và NVIDIA Spectrum-X, giúp giảm 56x thời gian tạo token đầu tiên cho mô hình AI ngữ cảnh dài.

Kiến trúc lưu trữ KV Cache phân tán vượt trội

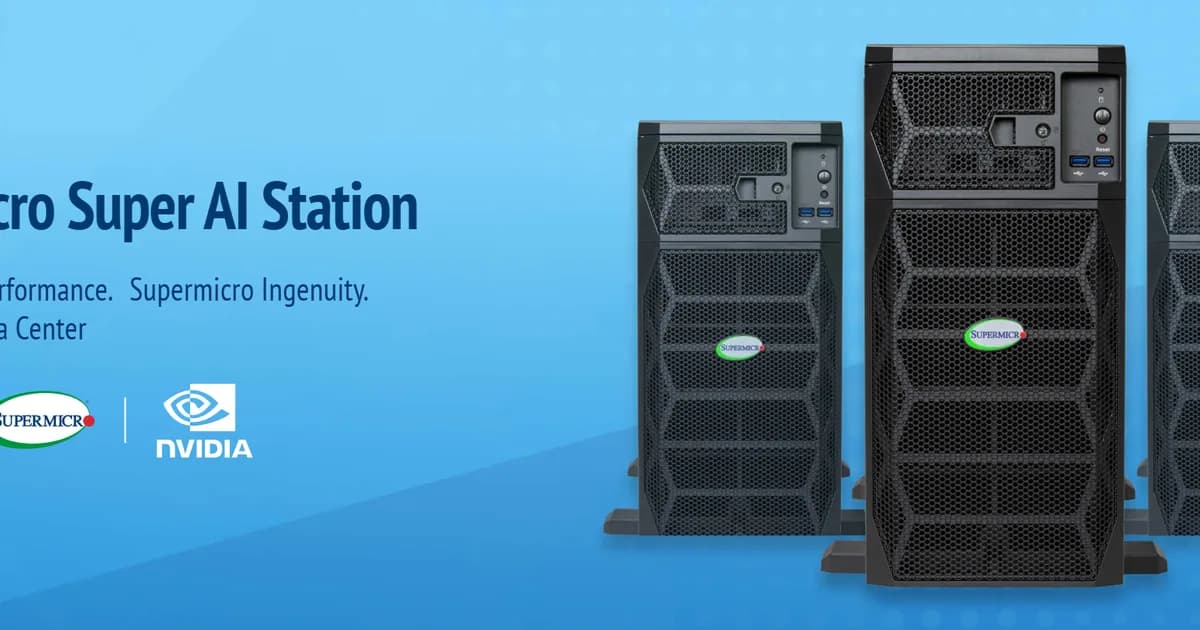
Supermicro chính thức công bố giải pháp lưu trữ KV Cache mới nhất, kết hợp cùng IBM Storage Scale và NVIDIA Dynamo. Kiến trúc này được thiết kế để xử lý bài toán bộ nhớ cho các tác vụ suy luận AI (AI inference) với ngữ cảnh dài, nơi dữ liệu trạng thái khóa-giá trị (key-value state) thường vượt quá khả năng chứa của GPU hoặc CPU đơn lẻ. Thay vì giữ toàn bộ dữ liệu KV Cache trong bộ nhớ tạm thời của GPU, giải pháp này đẩy phần dữ liệu này xuống một tầng lưu trữ flash chia sẻ tốc độ cao. Điều này cho phép hệ thống tái sử dụng ngữ cảnh cho các bước tiếp theo mà không cần tính toán lại từ đầu, giúp tối ưu hóa hiệu năng tổng thể của cụm máy chủ AI. Giải pháp được xây dựng dựa trên 8 máy chủ Supermicro ASG-1115S-NE316R Petascale, mỗi máy chạy bộ xử lý AMD EPYC 9535 đơn socket. Hệ thống sử dụng IBM Storage Scale Erasure Code Edition để quản lý tầng file chia sẻ và NVIDIA Dynamo để điều phối phân cấp cache, đảm bảo dữ liệu được truy xuất nhanh chóng qua mạng Ethernet tốc độ cao.

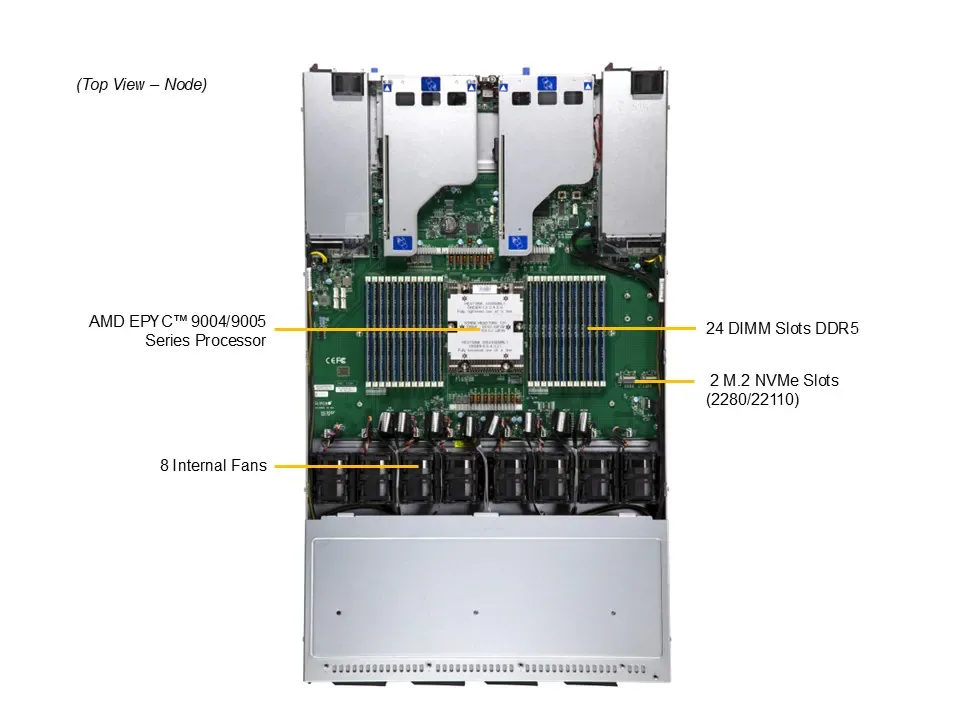
Supermicro ASG-1115S-NE316R máy chủ lưu trữ flash toàn phần 1U

Thông số kỹ thuật phần cứng và mạng lưới

Mỗi node trong kiến trúc này là một hệ thống 1U trang bị 16 khe cắm NVMe E3.S nóng (hot-swap), chứa tổng cộng 122.88TB bộ nhớ flash thô từ Micron. CPU AMD EPYC 9535 cung cấp 128 lane PCIe Gen 5, phân bổ đều cho lưu trữ và mạng lưới, đảm bảo băng thông không bị nghẽn cổ chai. Về mặt kết nối mạng, Supermicro tích hợp card NVIDIA BlueField-3 B3220 dual-port 200Gb ở phía client và ConnectX-7 400Gb cho backend lưu trữ. Toàn bộ cụm được kết nối qua 3 switch NVIDIA Spectrum-X SN5600 theo cấu trúc spine-leaf với đường lên 800Gb/s, tạo nên một hạ tầng mạng cực kỳ thông thoáng. Phần mềm chạy trên hệ thống là RHEL 9.6 và IBM Storage Scale ECE 6.0.0.1 với chế độ erasure code 8+2P. Theo tính toán của IBM, tầng lưu trữ 8 node này có khả năng đạt tốc độ đọc lên tới 315GB/s, đáp ứng nhu cầu băng thông khổng lồ cho các mô hình ngôn ngữ lớn (LLM).
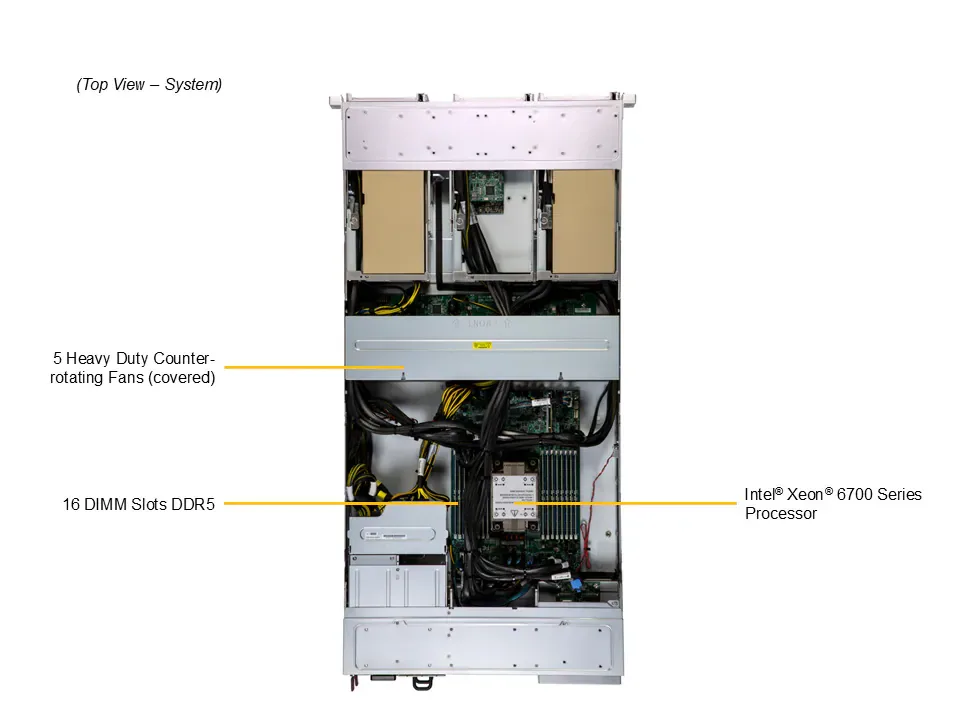
Siêu dữ liệu phần cứng Supermicro và IBM cho tải trọng AI

Giảm 56x thời gian tạo token đầu tiên

Trong các bài kiểm tra hiệu năng, nhóm nghiên cứu sử dụng một hệ thống Supermicro SYS-212GB-FNR MGX với GPU NVIDIA RTX PRO 6000 Blackwell để chạy mô hình openai/gpt-oss-120b. Kết quả cho thấy khi không có cache, thời gian tạo token đầu tiên (TTFT) tăng vọt từ 0.572 giây lên 32.14 giây khi độ dài ngữ cảnh đạt 130,000 tokens do GPU phải tính toán lại toàn bộ. Với KV Cache được lưu trữ trên tầng Supermicro IBM Storage Scale, TTFT duy trì ổn định trong khoảng từ 0.193 đến 0.57 giây ngay cả ở độ dài ngữ cảnh lớn nhất. Con số này tương đương mức cải thiện 56 lần so với phương pháp tính toán lại truyền thống. Bài kiểm tra thông lượng (throughput) cũng ghi nhận thành tích ấn tượng: hệ thống xử lý được 4.26 yêu cầu/giây, nhanh gấp 22 lần so với baseline không cache. Ngay cả khi có nhiễu mạng từ 4 client khác, hệ thống vẫn duy trì tốc độ cao hơn nhiều lần so với phương pháp cũ, nhờ khả năng cách ly lưu lượng của nền tảng NVIDIA Spectrum-X.

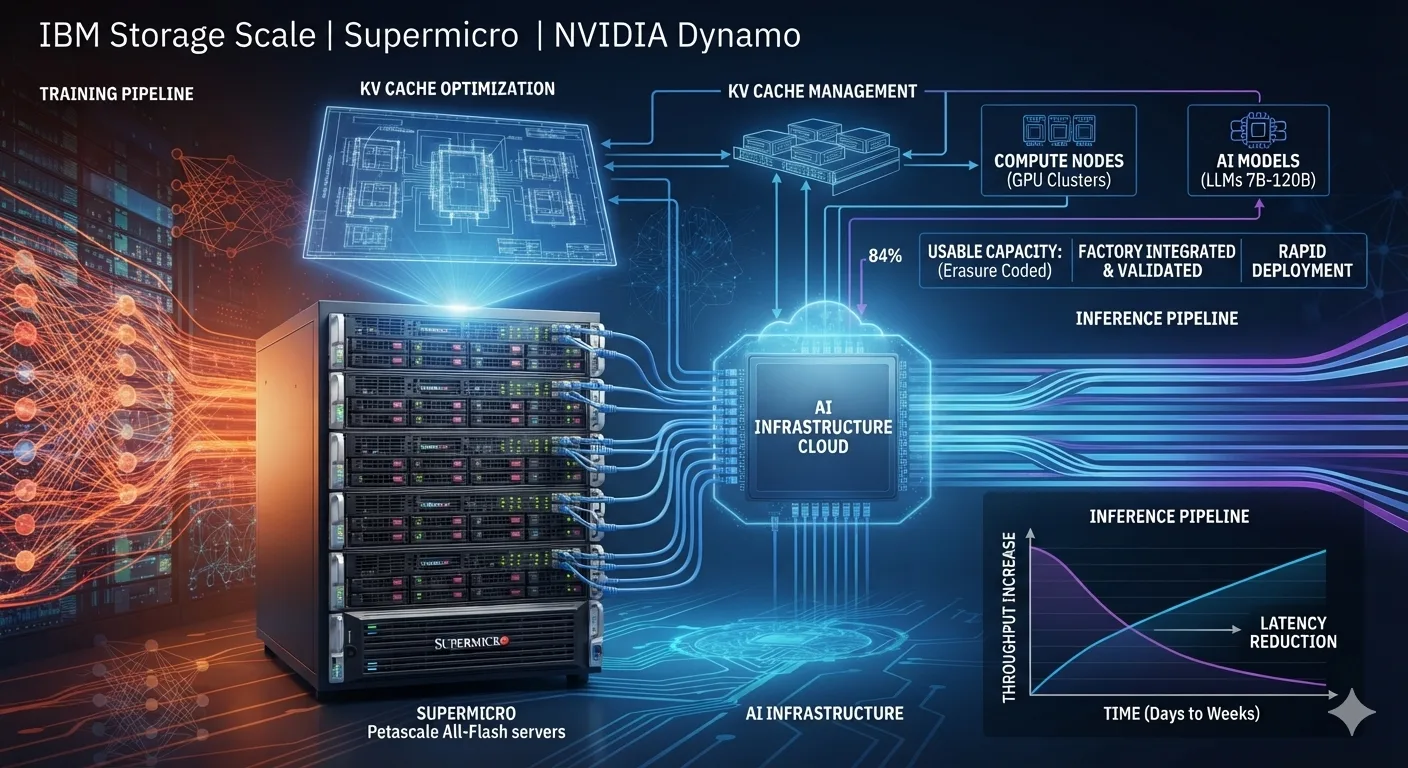
Cách giảm thiểu nút cổ chai KV Cache với NVIDIA Dynamo

Khả năng mở rộng và triển khai thực tế

IBM cung cấp hướng dẫn định cỡ cho giải pháp này, cho thấy khả năng mở rộng linh hoạt từ 4 node cho các mô hình nhỏ (7B-34B) lên đến 16 node hoặc hơn cho các mô hình lớn (70B-120B) và cụm GPU quy mô hàng trăm thiết bị. Dung lượng hữu dụng có thể đạt tới 84% với cấu hình erasure code phù hợp. Supermicro nhấn mạnh đây là giải pháp tích hợp sẵn, được tối ưu hóa từ nhà máy và hỗ trợ triển khai tại chỗ, giúp rút ngắn thời gian cài đặt từ nhiều tuần xuống còn vài ngày. Đây là bước đi chiến lược nhằm loại bỏ các nút cổ chai khi AI chuyển dịch từ giai đoạn huấn luyện sang suy luận thông lượng cao. Mặc dù chưa công bố giá bán chính thức và ngày mở bán, giải pháp KV Cache này cạnh tranh trực tiếp với các sản phẩm như DDN Dynamo-integrated KV cache acceleration. Điểm khác biệt nằm ở việc Supermicro sử dụng máy chủ thương mại (commodity servers) và Ethernet phổ biến, giúp doanh nghiệp dễ dàng tích hợp vào hạ tầng hiện có mà không phụ thuộc quá nhiều vào phần cứng độc quyền phức tạp.

Redbooks IBM về KV Cache hiệu năng cao cho ngữ cảnh không giới hạn
Cộng đồng: