Không có thông báo nào

Qualcomm xác nhận HBC thay thế HBM: AI250 ra mắt 2027 với băng thông gấp 18 lần

Qualcomm chính thức xác nhận silicon HBC đã hoàn tất kiểm thử, mở đường cho AI250 ra mắt năm 2027. Giải pháp LPDDR xếp chồng hứa hẹn băng thông hiệu dụng cao gấp 18 lần so với LPDDR5X.

Hoàn tất kiểm thử silicon HBC và lộ trình sản phẩm hóa

Qualcomm đã chính thức công bố rằng thế hệ đầu tiên của công nghệ Tính toán Băng thông Cao (High Bandwidth Compute - HBC) đã hoàn thành giai đoạn xác minh phần cứng tại phòng thí nghiệm ở San Diego. Bước tiến này đánh dấu việc kiểm chứng đầy đủ khả năng đọc/ghi bộ nhớ và tính toán gần bộ nhớ (near-memory computing), đưa giải pháp thay thế cho HBM từ giai đoạn ý tưởng sang giai đoạn sản phẩm hóa thực tế. Theo thông tin từ Qualcomm, chip silicon thử nghiệm đã chạy thành công đường truyền dữ liệu bộ nhớ đầy đủ và các phép tính gần bộ nhớ ở kích thước đại diện cho sản xuất, sử dụng thiết bị kiểm thử tự động tiêu chuẩn với trọng số và kích hoạt ngẫu nhiên. Đây là nền tảng kỹ thuật vững chắc để Qualcomm triển khai thương mại hóa kiến trúc này trong tương lai gần. Mục tiêu cốt lõi của HBC là giải quyết nút thắt cổ chai bộ nhớ trong suy luận AI (AI inference). Khi các mô hình ngôn ngữ lớn (LLM) chuyển dịch sang quy mô trung tâm dữ liệu, việc di chuyển dữ liệu giữa các cụm bộ nhớ và đơn vị xử lý trở thành yếu tố quyết định thông lượng, tiêu thụ năng lực và chi phí sở hữu tổng thể. HBC được thiết kế để đặt logic tính toán gần bộ nhớ hơn, giảm thiểu khoảng cách di chuyển dữ liệu và tăng băng thông hiệu dụng.
Qualcomm xác nhận silicon HBC đạt bước nhảy vọt 18 lần về băng thông bộ nhớ AI

Kiến trúc LPDDR xếp chồng: Vượt trội so với HBM4 về hiệu năng

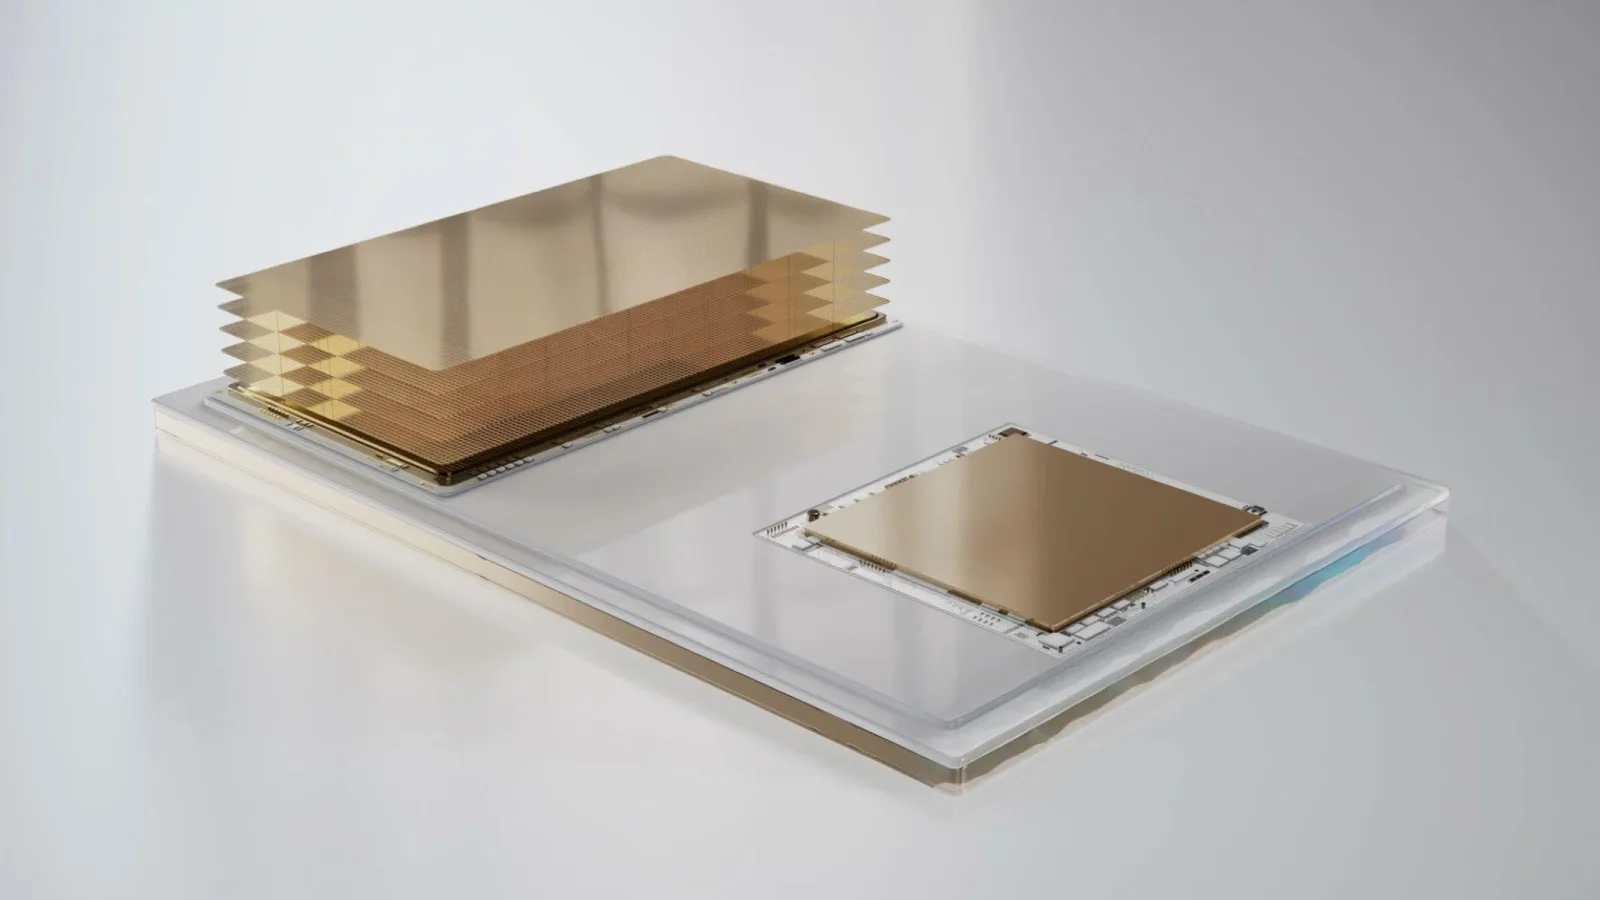
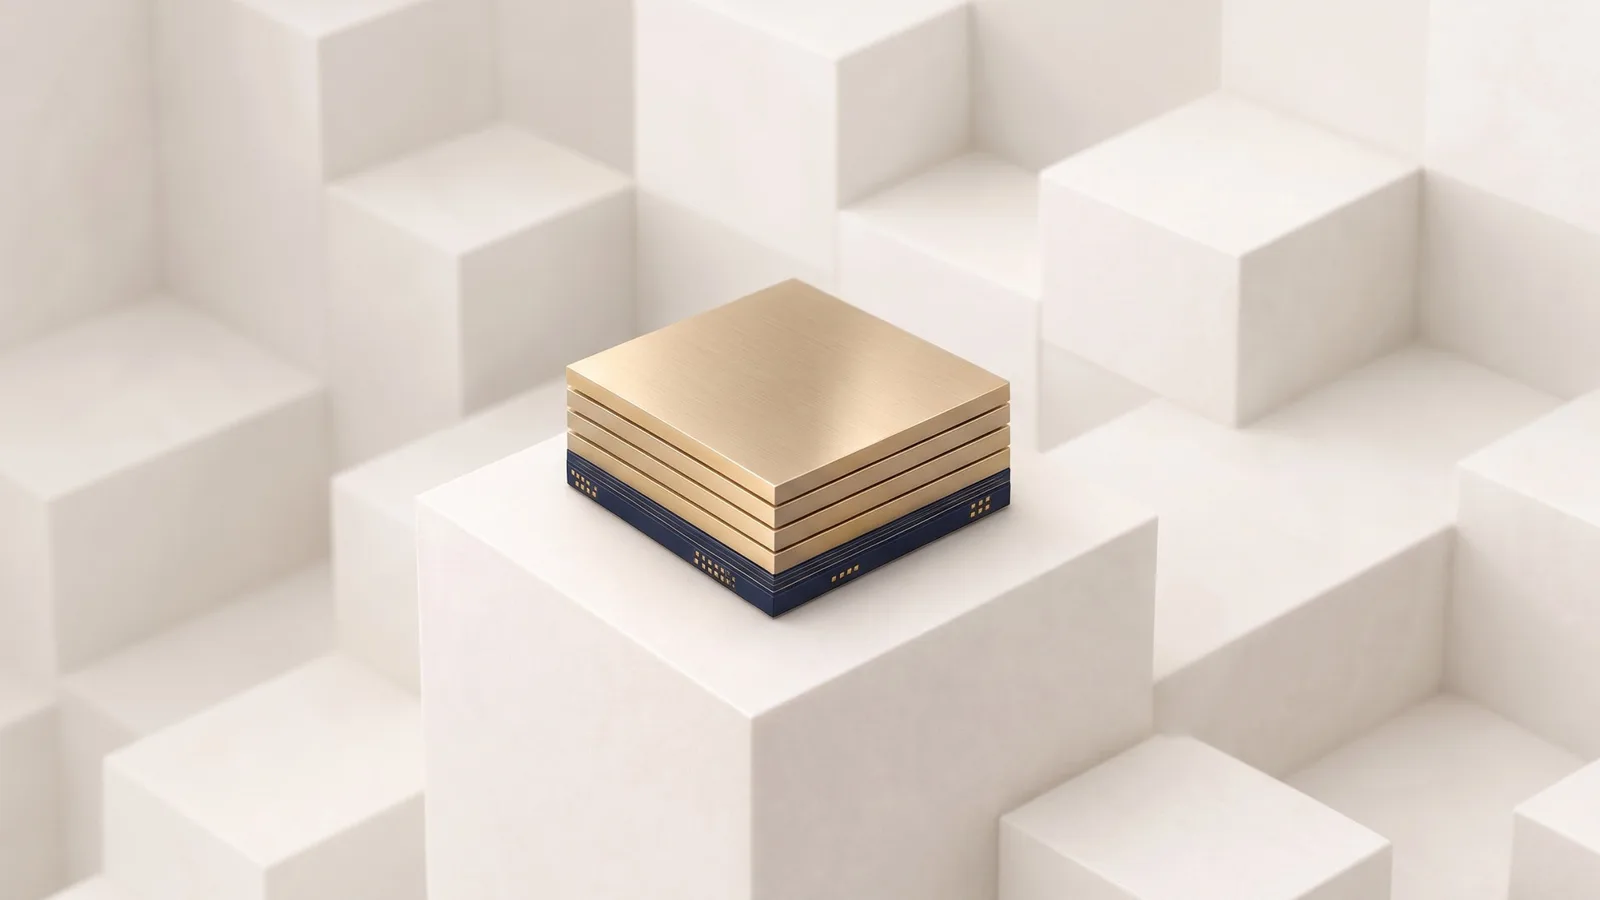
Khác với lộ trình truyền thống sử dụng HBM, Qualcomm lựa chọn giải pháp xếp chồng nhiều lớp bộ nhớ LPDDR công suất thấp lên trên chip nền AI accelerator thông qua kỹ thuật gắn kết wafer-to-wafer. Cách tiếp cận này thu hẹp khoảng cách di chuyển dữ liệu từ mức milimet xuống còn micromet, cho phép thực hiện các phép tính gần bộ nhớ ngay trong cùng một gói. Kết quả kiểm thử trên mẫu silicon hai lớp DRAM ban đầu cho thấy hiệu năng đáng kinh ngạc: băng thông bộ nhớ hiệu dụng tăng gấp 18 lần so với triển khai LPDDR5X và đạt hơn năm lần hiệu suất băng thông trên mỗi watt (bandwidth-per-watt) so với các thông số kỹ thuật dự kiến của HBM4. Mặc dù con số này thấp hơn một chút so với mục tiêu ban đầu là 6 lần mà Qualcomm từng đề ra, nhưng vẫn được xem là một chiến thắng lớn về mặt kỹ thuật. Để đảm bảo độ tin cậy cho sản phẩm thương mại, Qualcomm sẽ nâng cấp lên cấu hình xếp chồng bốn lớp DRAM. Kiến trúc này tích hợp các kỹ thuật dự phòng và ánh xạ lại (redundancy and remapping) để khắc phục các lỗi trong quá trình xếp chồng silicon, dựa trên hơn một thập kỷ nghiên cứu về tích hợp bộ nhớ 3D và định hình tiêu chuẩn JEDEC LPDDR.

Sơ đồ kiến trúc HBC accelerator của Qualcomm

AI250 và Dragonfly Rack: Thông số kỹ thuật ấn tượng cho trung tâm dữ liệu

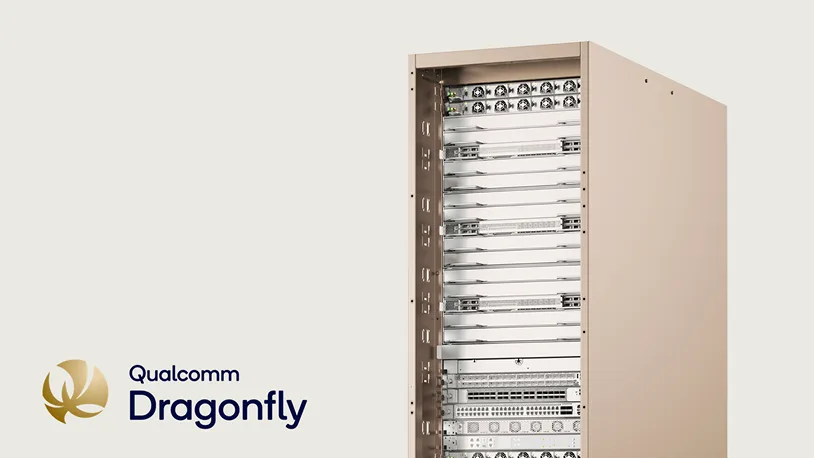
Sản phẩm đầu tiên ứng dụng công nghệ HBC là bộ tăng tốc AI250 thuộc dòng Dragonfly, dự kiến sẽ xuất xưởng mẫu thử nghiệm (sampling) cho khách hàng doanh nghiệp và các nhà siêu quy mô (hyperscalers) trong nửa đầu năm 2027. AI250 được thiết kế chuyên biệt cho các tác vụ suy luận phân tách (disaggregated inference). Một tủ rack Dragonfly AI250 hoàn chỉnh với hệ thống làm mát chất lỏng sẽ cung cấp dung lượng bộ nhớ hệ thống lên tới 38,6 TB và băng thông hiệu dụng đạt 7,4 petabyte/giây. Con số này đại diện cho sự đột phá về mật độ bộ nhớ và tốc độ truyền dữ liệu so với các giải pháp hiện tại. Lộ trình mở rộng của Qualcomm cũng đã được vạch ra rõ ràng: sau khi triển khai CPU máy chủ C1000 dựa trên nhân Oryon vào năm 2027, thế hệ HBC tiếp theo sẽ được tích hợp vào nền tảng Dragonfly AI300 vào năm 2028. Điều này cho thấy Qualcomm đang xây dựng một hệ sinh thái trung tâm dữ liệu đồng bộ từ CPU đến accelerator và bộ nhớ.

Qualcomm công bố lộ trình trung tâm dữ liệu Dragonfly cho kỷ nguyên AI tác nhân

Liên minh chiến lược: Samsung, SK Hynix và TSMC cùng thúc đẩy HBC

Để hiện thực hóa công nghệ HBC, Qualcomm không đơn độc mà đã thiết lập các thỏa thuận hợp tác đa năm với hơn 35 lãnh đạo ngành công nghiệp. Đáng chú ý, Samsung và SK Hynix đã chủ động đề xuất hợp tác để thúc đẩy thương mại hóa HBC, đóng vai trò then chốt trong việc sản xuất các lớp bộ nhớ LPDDR xếp chồng. TSMC sẽ đảm nhận khâu tích hợp và đóng gói (packaging) tiên tiến, đặc biệt là quy trình gắn kết wafer-to-wafer cần độ chính xác cực cao. Sự tham gia của các gã khổng lồ bán dẫn này giúp Qualcomm giải quyết các thách thức về sản xuất hàng loạt và nâng cao tỷ lệ chip tốt (yield rate). Việc Qualcomm chuyển dịch sang thị trường máy chủ với bộ tăng tốc AI250 và CPU C1000 đánh dấu một bước ngoặt quan trọng. Thay vì chỉ tập trung vào thiết bị di động, Qualcomm đang khẳng định vị thế trong phân khúc hạ tầng AI, cạnh tranh trực tiếp với các giải pháp HBM truyền thống bằng hiệu suất năng lượng và băng thông vượt trội.

Chi tiết kiến trúc bộ nhớ và xử lý trong hệ sinh thái Dragonfly của Qualcomm
Cộng đồng: