Không có thông báo nào

Google Cloud và NVIDIA chính thức ra mắt hạ tầng Vera Rubin NVL72: Đột phá cho AI Agent và Reinforcement Learning

Google Cloud và NVIDIA công bố khả năng sử dụng chung (General Availability) cho các instance A5X được đẩy mạnh bởi NVIDIA Vera Rubin NVL72. Hệ thống này tích hợp ConnectX-9 SuperNICs và công nghệ làm mát lỏng thế hệ 4, hỗ trợ quy mô lên đến 960.000 GPU cho các tác vụ AI Agent và Reinforcement Learning.

Triển khai hạ tầng Vera Rubin NVL72 quy mô lớn tại Google Cloud

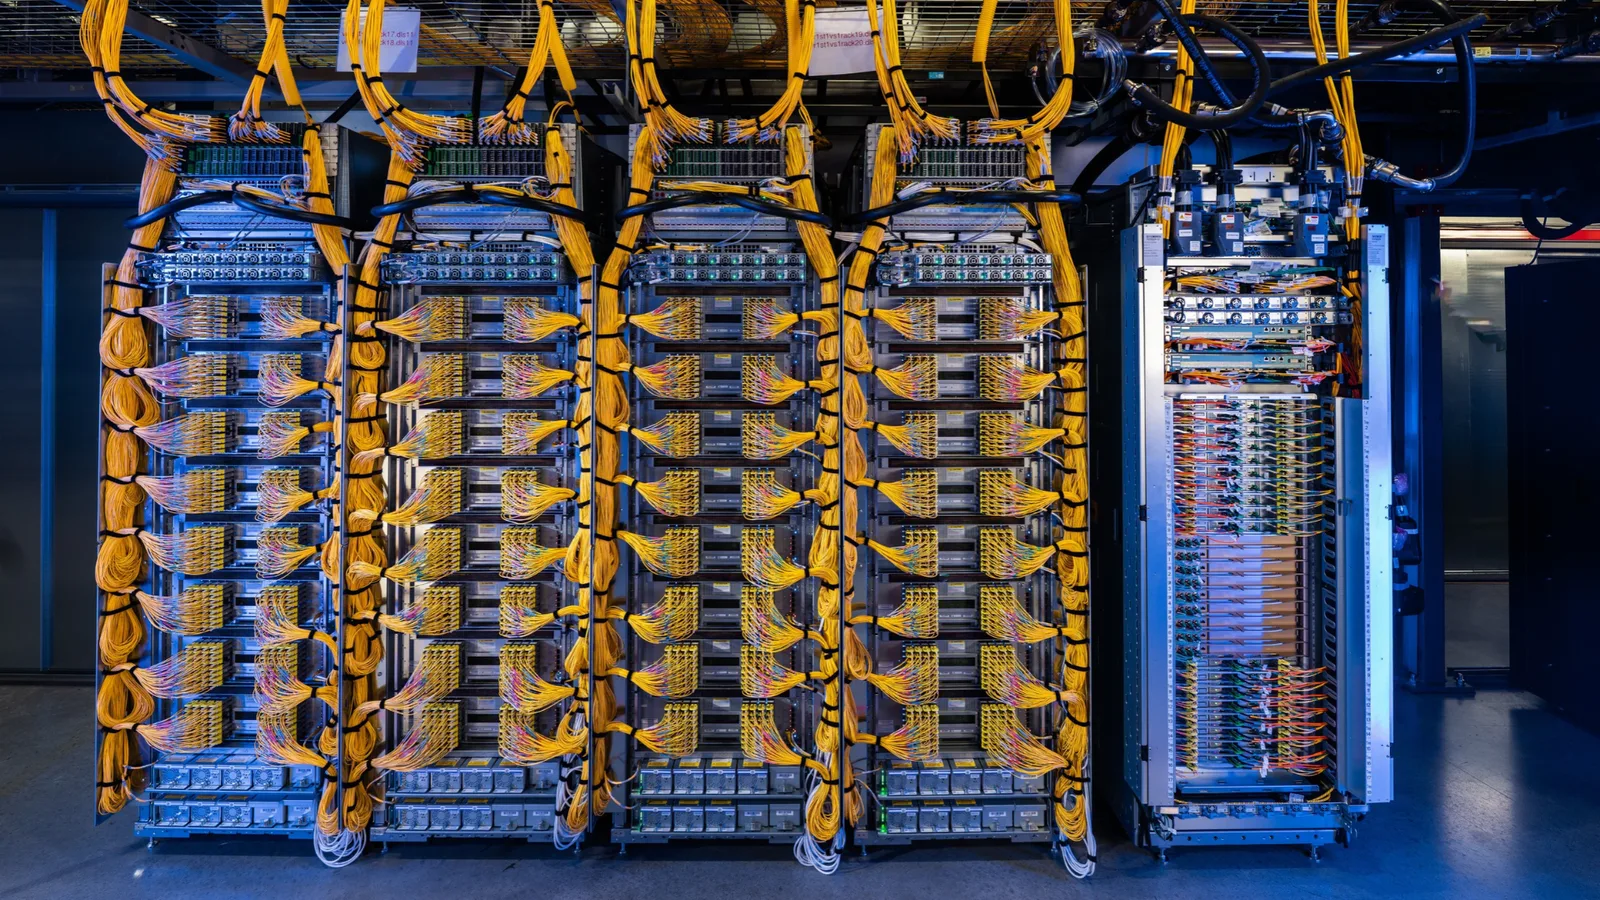
Google Cloud và NVIDIA vừa chính thức công bố khả năng sử dụng chung (General Availability) cho các instance A5X, đánh dấu bước tiến quan trọng trong việc tích hợp NVIDIA Vera Rubin NVL72 vào hệ sinh thái AI Hypercomputer. Sự kiện này không chỉ đơn thuần là việc ra mắt phần cứng mới mà còn là sự khẳng định vị thế của Google Cloud trong việc cung cấp nền tảng tích hợp liền mạch cho các tác vụ huấn luyện, suy luận (inference) và Reinforcement Learning (RL) quy mô lớn. Theo công bố từ NVIDIA, kế hoạch mở rộng hạ tầng dựa trên Vera Rubin của Google Cloud sẽ đạt quy mô lên đến 960.000 GPU Rubin trên nhiều địa điểm khác nhau. Con số này cho thấy tham vọng khổng lồ trong việc xây dựng một hệ sinh thái AI có khả năng xử lý các mô hình ngôn ngữ lớn và các tác vụ tính toán phức tạp nhất hiện nay. Việc General Availability được dự kiến diễn ra vào tháng tới, kèm theo kế hoạch mở rộng khả năng tiếp cận sang khu vực châu Âu, sẽ giúp các nhà đổi mới sáng tạo tại đây tiếp cận sớm với thế hệ hạ tầng AI tiếp theo. Hệ thống A5X không chỉ là sự kết hợp đơn lẻ của các thành phần phần cứng, mà là một nền tảng tích hợp sâu giữa tính toán, mạng và lưu trữ. Sự ra đời của A5X đánh dấu sự chuyển dịch từ việc cung cấp các tài nguyên máy chủ rời rạc sang việc cung cấp một hệ thống AI hoàn chỉnh, tối ưu hóa cho các luồng công việc (workflows) đặc thù của kỷ nguyên AI Agent.

Hạ tầng NVIDIA Vera Rubin NVL72 được tích hợp vào Google Cloud A5X instances, hỗ trợ quy mô 960.000 GPU

Tối ưu hóa hiệu năng với ConnectX-9 SuperNICs và làm mát lỏng thế hệ 4

Điểm nhấn kỹ thuật nổi bật nhất của instance A5X nằm ở sự kết hợp giữa NVIDIA Vera Rubin NVL72 và NVIDIA ConnectX-9 SuperNICs. Trong bối cảnh các mô hình AI ngày càng phức tạp, yêu cầu băng thông truyền tải dữ liệu giữa các GPU và CPU trở thành yếu tố quyết định hiệu năng. ConnectX-9 SuperNICs đóng vai trò then chốt trong việc giảm thiểu độ trễ và tăng tốc độ truyền tải dữ liệu, đảm bảo rằng các tác vụ tính toán song song được thực hiện một cách liền mạch và hiệu quả. Bên cạnh đó, Google Cloud đã tích hợp công nghệ làm mát lỏng (liquid-cooling) thế hệ thứ tư tiên tiến vào hệ thống A5X. Đây là giải pháp thiết yếu để duy trì hiệu năng ổn định (sustained performance) của các GPU Rubin trong môi trường hoạt động liên tục 24/7. Với mật độ công suất ngày càng cao, việc quản lý nhiệt trở thành thách thức lớn, và công nghệ làm mát lỏng thế hệ 4 giúp giải quyết vấn đề này, cho phép các hệ thống hoạt động ở mức công suất tối đa mà không gặp phải hiện tượng Thermal Throttling. Sự kết hợp giữa băng thông mạng cao cấp từ ConnectX-9 và khả năng tản nhiệt vượt trội tạo nên một nền tảng lý tưởng cho các tác vụ Agentic Inference và Reinforcement Learning. Những tác vụ này đòi hỏi sự tương tác liên tục giữa các thành phần phần cứng, nơi mà bất kỳ sự chậm trễ nào trong truyền tải dữ liệu hoặc sự sụt giảm hiệu năng do nhiệt độ đều có thể ảnh hưởng trực tiếp đến tốc độ hội tụ của mô hình.

Thúc đẩy Reinforcement Learning với nền tảng Superlearner

Ineffable Intelligence, công ty công nghệ có trụ sở tại London do David Silver - người sáng tạo ra AlphaGo - thành lập, là khách hàng đầu tiên tiếp cận với instance A5X. Công ty đang sử dụng nền tảng này để phát triển các hệ thống "superlearner" - những mô hình AI có khả năng học hỏi liên tục từ trải nghiệm thực tế. Đây là một hướng tiếp cận tiên tiến trong lĩnh vực Reinforcement Learning, nơi mà AI không chỉ được huấn luyện một lần mà còn tự cải thiện qua từng tương tác. Theo David Silver, việc xây dựng các superlearner đòi hỏi một chu trình liên tục: tạo ra trải nghiệm, đánh giá kết quả và cập nhật mô hình. Quá trình này yêu cầu hạ tầng có khả năng hỗ trợ toàn bộ chu trình ở quy mô lớn. Vera Rubin, với sự kết hợp giữa hiệu năng tính toán vượt trội và kết nối băng thông cao giữa CPU Vera và GPU Rubin, cũng như giữa các GPU Rubin trong cùng một rack, cho phép Ineffable Intelligence đẩy mạnh quy mô và tham vọng nghiên cứu của họ. Khả năng kết nối chặt chẽ giữa việc tạo ra trải nghiệm và việc huấn luyện trên đó là yếu tố then chốt. Mỗi sự cải thiện của agent có thể nhanh chóng định hình trải nghiệm tiếp theo của nó, tạo ra một vòng lặp phản hồi (feedback loop) hiệu quả. Hạ tầng A5X chính là nền tảng vật lý hỗ trợ cho vòng lặp này, đảm bảo rằng dữ liệu từ trải nghiệm được xử lý và tích hợp vào mô hình một cách nhanh chóng và chính xác.
Ứng dụng thực tế trong Creative Agent và bảo mật AI

WPP, công ty marketing và truyền thông hàng đầu tại London, cũng đã chứng minh kiến trúc tham chiếu (reference architecture) cho Creative Agent của mình trên các instance A5X dựa trên NVIDIA Vera Rubin. Sử dụng các mô hình NVIDIA Nemotron và NVIDIA OpenShell - một phần của NVIDIA OpenShell Reference Architecture cho các AI Agent an toàn - WPP đã biến các yêu cầu hội thoại thành các quy trình sáng tạo đa bước, bao gồm tạo video, nâng cấp độ phân giải và thay đổi phong cách. Một điểm đáng chú ý trong các thử nghiệm ban đầu của WPP là các tác vụ vốn yêu cầu một cụm đa node (multi-node cluster) giờ đây có thể được thực hiện trên một instance A5X duy nhất. Điều này cho thấy hiệu năng tính toán và băng thông của Vera Rubin NVL72 đã đạt đến mức mà các tác vụ phức tạp trước đây cần đến nhiều máy chủ giờ đây có thể được xử lý tập trung, giảm thiểu độ trễ và tăng tốc độ phản hồi. OpenShell đóng vai trò quan trọng trong việc cung cấp các sandbox được quản lý (governed sandboxes) cho việc thực thi agent. Điều này giúp kiểm soát quyền truy cập vào các tài sản thương hiệu nhạy cảm và các công cụ sáng tạo, đảm bảo rằng các AI Agent hoạt động trong một môi trường an toàn và tuân thủ các chính sách bảo mật của doanh nghiệp. Sự kết hợp giữa hiệu năng cao và bảo mật chặt chẽ làm cho A5X trở thành lựa chọn lý tưởng cho các ứng dụng doanh nghiệp trong kỷ nguyên AI Agent.

Bảo mật Confidential Computing và tối ưu hóa năng lượng

Khi các tổ chức triển khai các hệ thống Agentic, việc bảo vệ các mô hình độc quyền và dữ liệu nhạy cảm là một yêu cầu cấp thiết, đặc biệt khi chạy trên hạ tầng mà họ không sở hữu. Google Cloud sẽ là một trong những nhà cung cấp cloud đầu tiên cung cấp NVIDIA Confidential Computing ở quy mô rack trên các instance bare metal như A4X Max, được đẩy mạnh bởi NVIDIA GB300 NVL72. Điều này mở ra một tiêu chuẩn mới về bảo mật trong môi trường cloud, nơi mà dữ liệu và mã nguồn được bảo vệ ngay cả trong quá trình xử lý. Ngoài ra, Google Cloud cũng đang đưa Confidential Computing vào khả năng sử dụng chung (generally available) trên các G4 VMs được trang bị NVIDIA RTX PRO 6000 Blackwell Server Edition GPUs. Nền tảng linh hoạt này cung cấp khả năng suy luận (inference) và tinh chỉnh (fine-tuning) bảo mật, đáp ứng nhu cầu của các khách hàng như Vertebrae, Polaris Cloud và Confidential Core AI trong việc đảm bảo quyền riêng tư hội thoại và thực thi agent có thể kiểm chứng. Để hỗ trợ việc triển khai hiệu quả về năng lượng ở quy mô lớn, Google Cloud và NVIDIA đang khám phá các khả năng của NVIDIA DSX MaxLPS cho hạ tầng dựa trên Vera Rubin. Mục tiêu là tối ưu hóa hiệu năng trên mỗi watt (performance per watt) và mở rộng khả năng xử lý trong phạm vi ngân sách công suất trung tâm dữ liệu hiện có. Trong bối cảnh nguồn lực năng lượng ngày càng khan hiếm, việc tối ưu hóa hiệu suất năng lượng không chỉ là một yếu tố kỹ thuật mà còn là một yêu cầu bắt buộc để đảm bảo tính bền vững và khả năng mở rộng của hạ tầng AI.

Cộng đồng: