Không có thông báo nào

HPE Private Cloud AI: Tích hợp MCP Servers, Cluster GPU H200 & RTX PRO 6000 và Rack 256 CPU Vera

HPE nâng cấp HPE Private Cloud AI với MCP Servers, khả năng kết hợp GPU H200 và RTX PRO 6000, cùng rack 256 CPU Vera cho tác vụ AI agent, mang lại hiệu năng cao và kiểm soát chặt chẽ.

Tích hợp MCP Servers và API có kiểm soát cho AI Agents

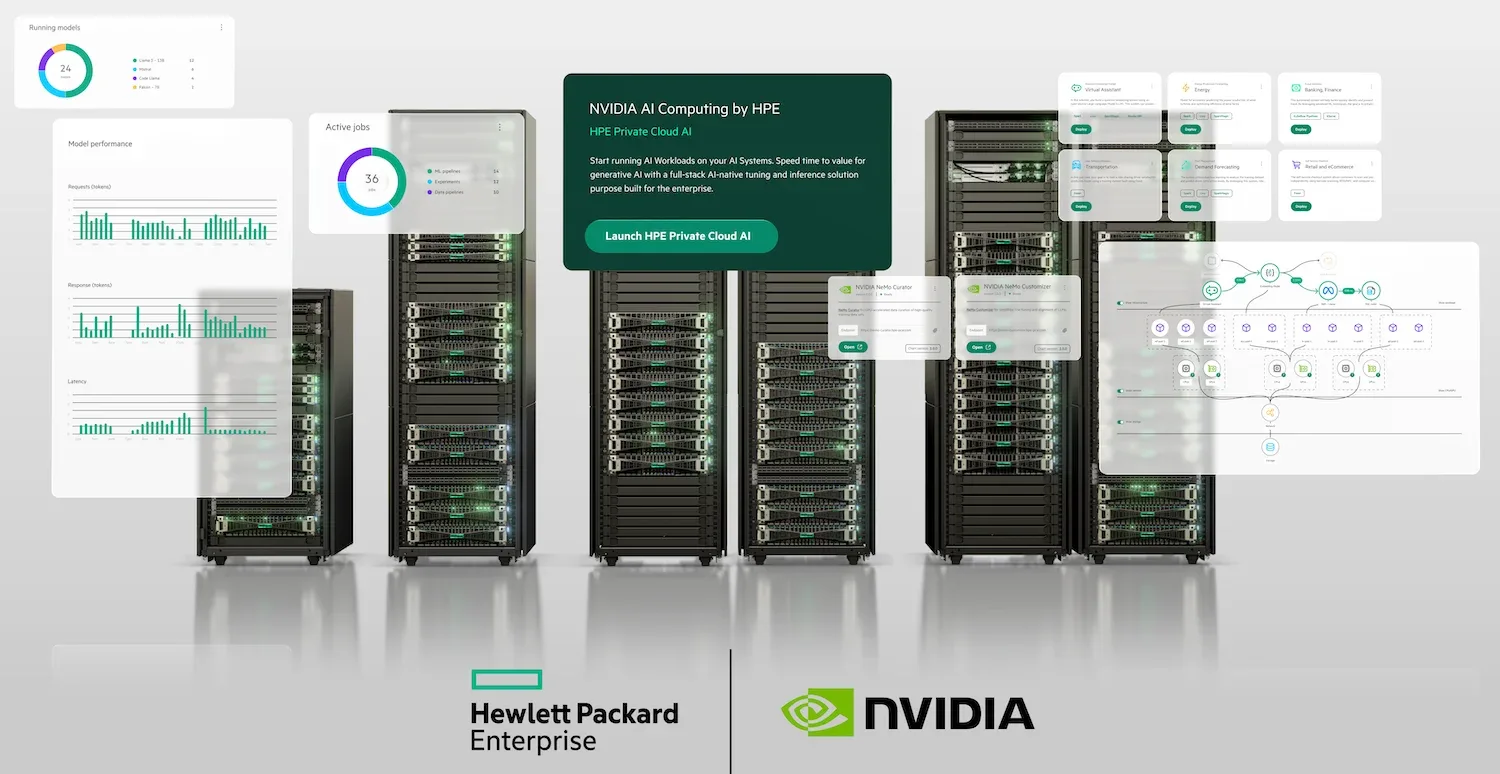
Tại sự kiện NVIDIA GTC Berlin, HPE đã công bố các bản cập nhật quan trọng cho nền tảng HPE Private Cloud AI, tập trung vào việc mở rộng khả năng tiếp cận cho các nhà phát triển, ISV và đặc biệt là các AI agents. Điểm nhấn nổi bật nhất là sự ra mắt của các MCP Servers (Model Context Protocol) và API cấp sản xuất, cho phép các tác nhân AI tự động truy cập vào hệ thống suy luận (inference), mô hình và pipeline dữ liệu của doanh nghiệp một cách có kiểm soát. Khác với các giải pháp đám mây công cộng, HPE Private Cloud AI áp dụng cơ chế quản lý danh tính tập trung và kiểm soát quyền truy cập dựa trên vai trò (RBAC). Điều này đảm bảo rằng mọi thao tác của AI agents đều được ghi lại trong nhật ký kiểm toán (audit logging), đáp ứng các yêu cầu khắt khe về bảo mật và tuân thủ quy định trong các ngành nghề nhạy cảm như tài chính, y tế và sản xuất. Theo công bố từ HPE, nền tảng này sử dụng OpenAPI làm nguồn sự thật duy nhất cho mọi giao diện được hỗ trợ, giúp tự động hóa việc tạo tài liệu, SDK và mã mẫu. Cách tiếp cận này không chỉ giảm thiểu sự phức tạp trong tích hợp mà còn đảm bảo tính nhất quán cao giữa các thành phần phần mềm, cho phép các doanh nghiệp triển khai AI agents trong môi trường hybrid hoặc air-gapped mà không phải hy sinh khả năng kiểm soát dữ liệu.
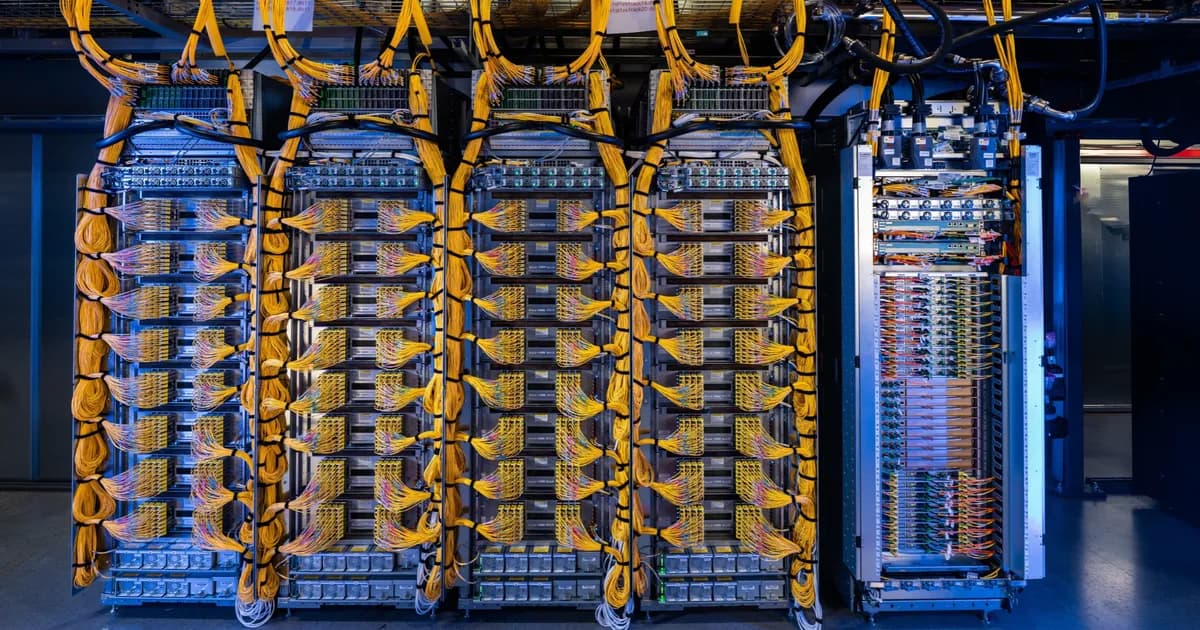
Giao diện HPE Private Cloud AI với các rack máy chủ NVIDIA AI Computing và bảng điều khiển hiệu năng mô hình

Khả năng kết hợp GPU H200 và RTX PRO 6000 Blackwell trong cùng một Cluster

Một trong những tính năng kỹ thuật đột phá được HPE giới thiệu là khả năng vận hành các cụm máy chủ (cluster) kết hợp giữa GPU NVIDIA H200 và RTX PRO 6000 Blackwell Server Edition. Thay vì phải tách biệt các tài nguyên phần cứng theo loại GPU, doanh nghiệp giờ đây có thể đặt các tác vụ AI khác nhau lên các loại GPU phù hợp nhất trong cùng một môi trường quản lý và kiểm soát tập trung. Tính năng này đã được đưa vào sử dụng chung (Generally Available) và đi kèm với bộ lịch trình KAI Scheduler mã nguồn mở của NVIDIA. KAI Scheduler hỗ trợ việc phân bổ tài nguyên dựa trên hạn mức (quota-based) và độ ưu tiên (priority-based), giúp tối ưu hóa hiệu suất sử dụng GPU và cải thiện việc đặt tác vụ (workload placement) trên toàn bộ hệ thống. Việc kết hợp các thế hệ GPU khác nhau trong một cluster giúp doanh nghiệp linh hoạt hơn trong việc cân bằng giữa chi phí và hiệu năng. Các tác vụ cần hiệu năng suy luận cao có thể được chạy trên H200, trong khi các tác vụ cần xử lý đồ họa hoặc suy luận tại biên (edge inference) có thể tận dụng RTX PRO 6000, tất cả đều được quản lý thống nhất qua console của HPE Private Cloud AI.

Sơ đồ kiến trúc HPE Private Cloud AI với các cụm GPU H200 và RTX PRO 6000 Blackwell

Rack 256 CPU NVIDIA Vera: Giải pháp cho các tác vụ AI Agent nặng

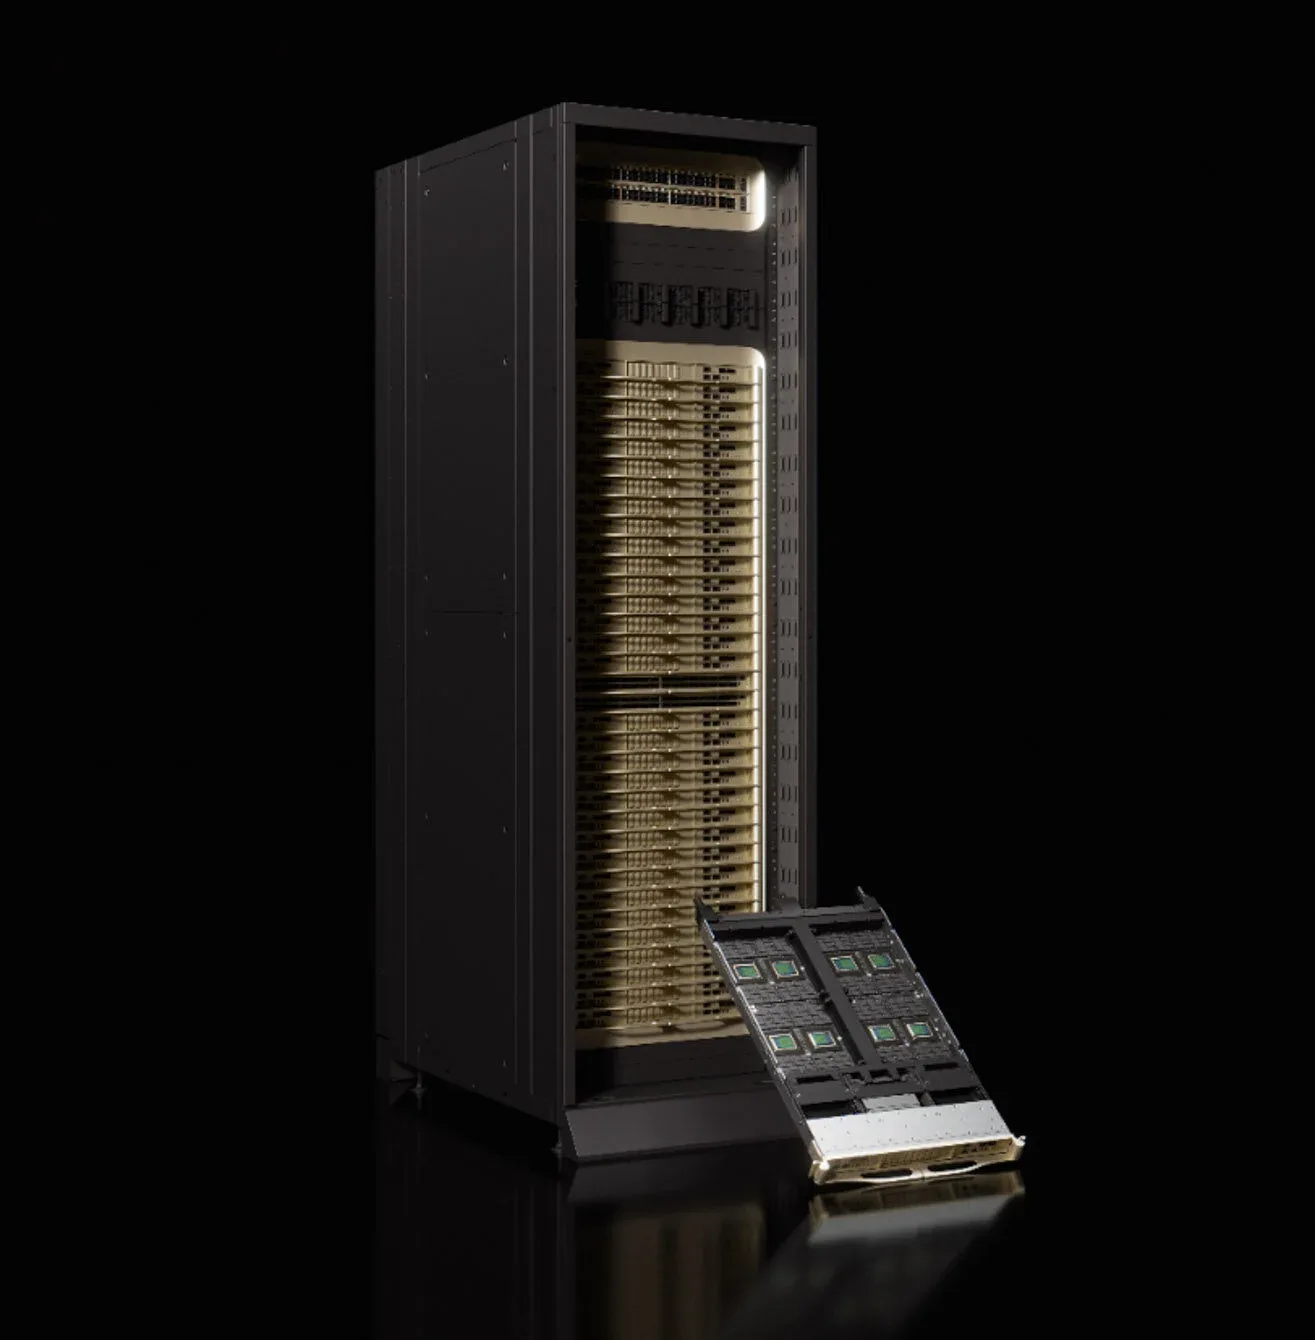
Để đáp ứng nhu cầu ngày càng tăng của các tác vụ AI agent và học tăng cường (reinforcement learning), HPE đã ra mắt NVIDIA Vera CPU Rack. Đây là một giải pháp phần cứng chuyên biệt, tập trung vào hiệu năng CPU cho các tác vụ như sandbox agent, đánh giá RL và pipeline xử lý dữ liệu, thường chạy song song với cơ sở hạ tầng GPU. Rack này được trang bị hệ thống làm mát bằng chất lỏng (liquid-cooled) và tích hợp 256 CPU Vera, hỗ trợ hơn 22.500 sandbox đồng thời. HPE tuyên bố rằng giải pháp này mang lại hiệu năng CPU cho các tác vụ agent nhanh hơn 80% so với cơ sở hạ tầng CPU truyền thống, mặc dù nhà sản xuất không công bố cụ thể cấu hình kiểm tra cơ sở. Việc tách biệt phần xử lý CPU và GPU trong kiến trúc này giúp tối ưu hóa hiệu suất tổng thể của hệ thống AI. Trong khi GPU tập trung vào các phép toán ma trận và suy luận, CPU Vera đảm nhận các tác vụ điều phối, xử lý logic phức tạp và quản lý trạng thái của các AI agents, tạo nên một hệ sinh thái phần cứng hoàn chỉnh cho kỷ nguyên AI tự chủ.

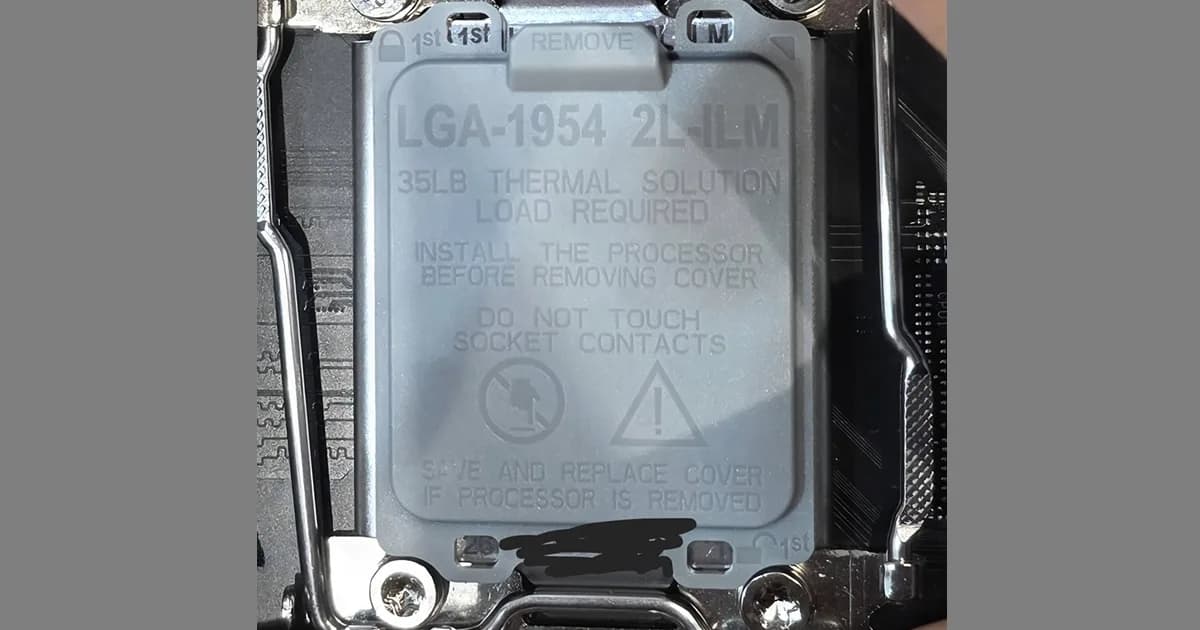
Ảnh render NVIDIA Vera CPU Rack với khay tính toán được rút ra, hiển thị các ổ cắm bộ xử lý

Tối ưu hóa hiệu năng và chi phí so với đám mây công cộng

HPE nhấn mạnh rằng HPE Private Cloud AI không chỉ là một giải pháp kỹ thuật mà còn là một lựa chọn kinh tế vượt trội. Theo dữ liệu từ HPE, việc sử dụng nền tảng này có thể giúp doanh nghiệp tiết kiệm đến 60% chi phí so với việc sử dụng đám mây công cộng, đặc biệt là khi triển khai các AI agents hoạt động liên tục 24/7. Trong môi trường đám mây công cộng, mỗi tương tác của AI agent đều được tính phí theo mức sử dụng (usage-based), dẫn đến chi phí có thể tăng vọt khi quy mô triển khai mở rộng. Ngược lại, HPE Private Cloud AI cung cấp một nền tảng chuyên dụng gần với dữ liệu doanh nghiệp, giúp kiểm soát chi phí ổn định và giảm độ trễ (latency) cho các tác vụ sản xuất. Ngoài ra, nền tảng này còn hỗ trợ việc triển khai nhanh chóng, với thời gian cài đặt có thể rút ngắn xuống dưới 8 giờ. Điều này cho phép các doanh nghiệp chuyển đổi từ ý tưởng AI sang môi trường sản xuất trong vài tuần thay vì vài tháng, nhờ vào các blueprints đã được xác thực và công cụ tự dịch vụ (self-service) tích hợp sẵn.

Giao diện chính thức của HPE Private Cloud AI từ trang web của nhà sản xuất

Thời gian ra mắt và lộ trình triển khai

Các bản cập nhật cho HPE Private Cloud AI, bao gồm khả năng truy cập API và MCP Servers cho nhà phát triển và ISV, dự kiến sẽ được triển khai vào cuối năm 2026. Trong khi đó, trải nghiệm tự dịch vụ hoàn chỉnh, bao gồm đăng ký ứng dụng và agent, khám phá API và MCP, cùng quản lý thông tin xác thực, sẽ được cung cấp vào năm 2027. Tuy nhiên, các tính năng quan trọng như khả năng trộn GPU H200 và RTX PRO 6000 Blackwell Server Edition cùng bộ lịch trình KAI đã sẵn sàng để sử dụng ngay lập tức. Điều này cho phép các doanh nghiệp bắt đầu tận dụng lợi ích của kiến trúc GPU hỗn hợp ngay trong giai đoạn hiện tại. HPE cũng đang hợp tác với Schneider Electric để kết hợp HPE Private Cloud AI với chuyên môn công nghiệp của đối tác, nhằm hỗ trợ các AI Agents công nghiệp tại biên (Edge). Mục tiêu là đưa suy luận AI gần hơn với nơi ra quyết định vận hành, đồng thời giữ quyền kiểm soát chặt chẽ đối với dữ liệu nhạy cảm, mở ra cơ hội lớn cho các ứng dụng AI trong sản xuất và logistics.

Cộng đồng: