Không có thông báo nào

Microsoft ra mắt Maia 300: Chip AI 2nm đầu tiên với 288GB HBM4 và hiệu năng suy luận vượt trội

Microsoft công bố chip AI Maia 300 dùng tiến trình TSMC N2P, trang bị 288GB HBM4 với băng thông 18TB/s, dự kiến triển khai quy mô đa gigawatt từ 2027.

Ra mắt thế hệ thứ ba: Định vị hệ thống suy luận AI chủ lực

Microsoft chính thức giới thiệu Maia 300, thế hệ thứ ba của nền tảng suy luận AI tùy chỉnh, đánh dấu bước tiến quan trọng trong chiến lược tự chủ hạ tầng phần cứng. Theo thông cáo từ Microsoft, chip này được thiết kế đặc biệt cho các tác vụ AI mới nổi như suy luận ngữ cảnh dài, trải nghiệm hội thoại độ trễ thấp và các tác vụ agent đa bước liên tục. Maia 300 không chỉ đơn thuần là một con chip mà được định vị là hệ thống suy luận AI chính (primary AI inference system) cho các sản phẩm và dịch vụ của Microsoft, bao gồm Microsoft 365 Copilot, GitHub Copilot và Microsoft Foundry. Mục tiêu cốt lõi là tối ưu hóa toàn bộ hệ thống để mỗi watt điện và mỗi đô la đầu tư đều tạo ra nhiều trí tuệ nhân tạo hữu ích nhất. Việc ra mắt Maia 300 phản ánh sự chuyển dịch trong nhu cầu tính toán AI, nơi các tác vụ agent (agentic workloads) đòi hỏi khả năng duy trì tính cục bộ (locality), cung cấp đủ dung lượng và băng thông bộ nhớ, đồng thời giảm thiểu di chuyển dữ liệu trong các giới hạn năng lượng và làm mát cố định của trung tâm dữ liệu.

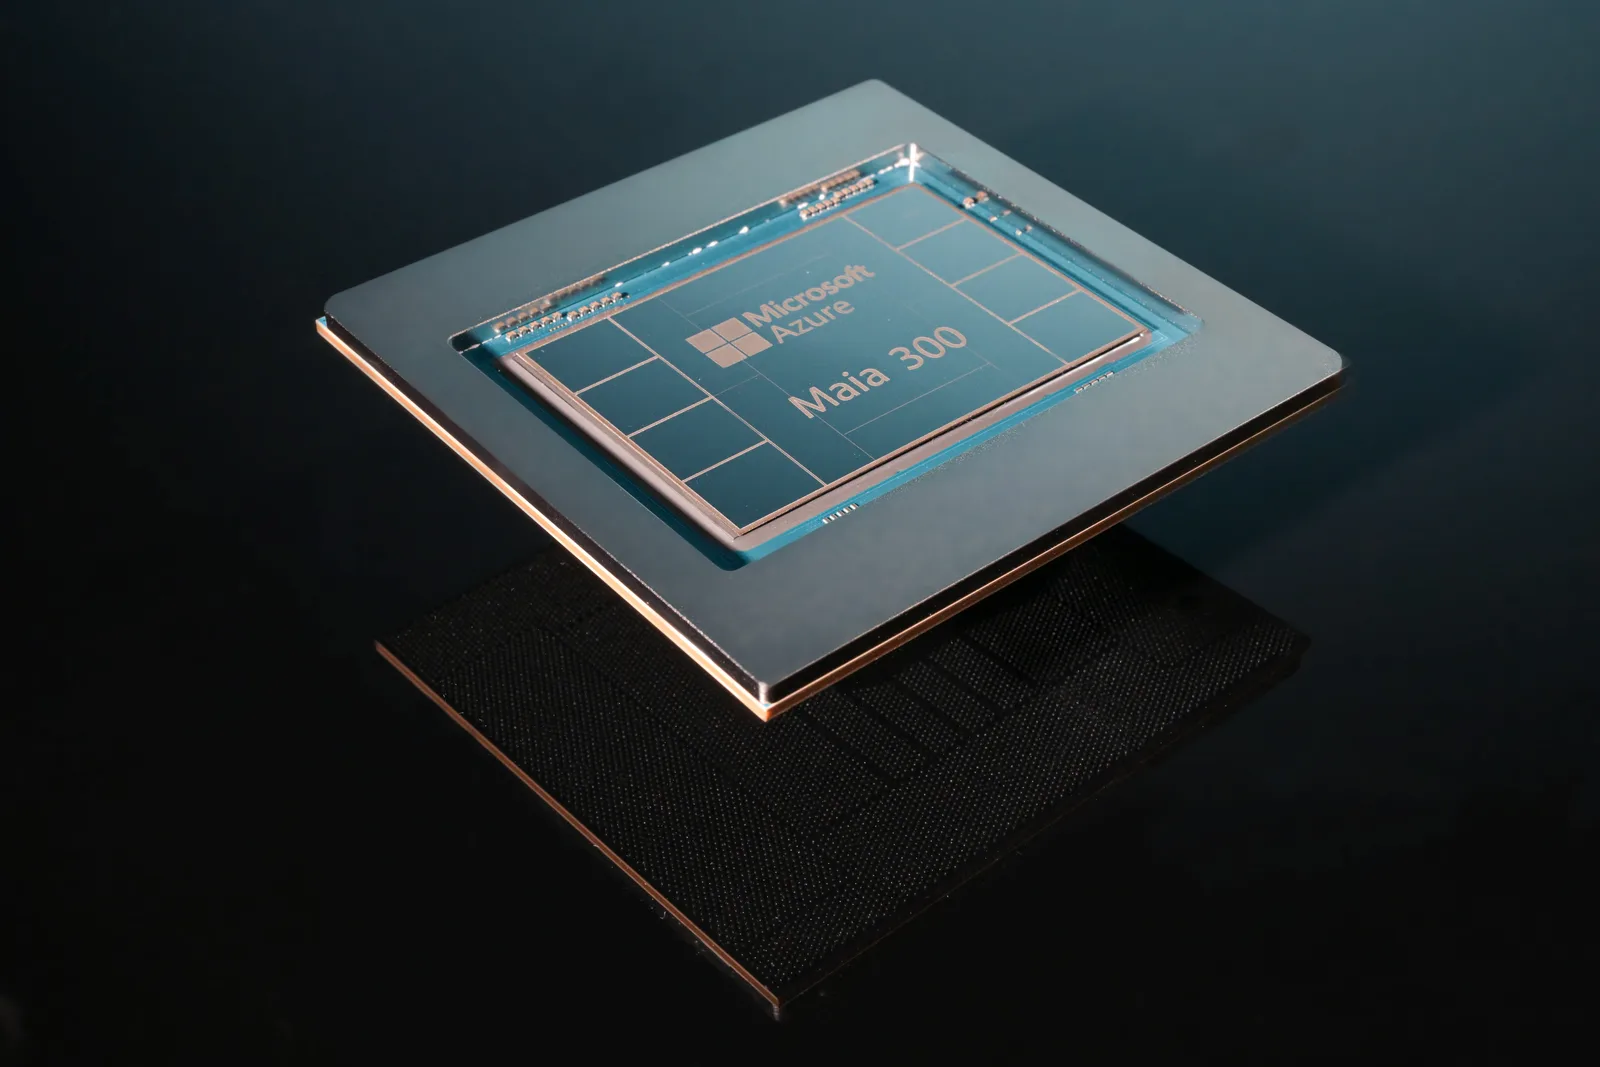
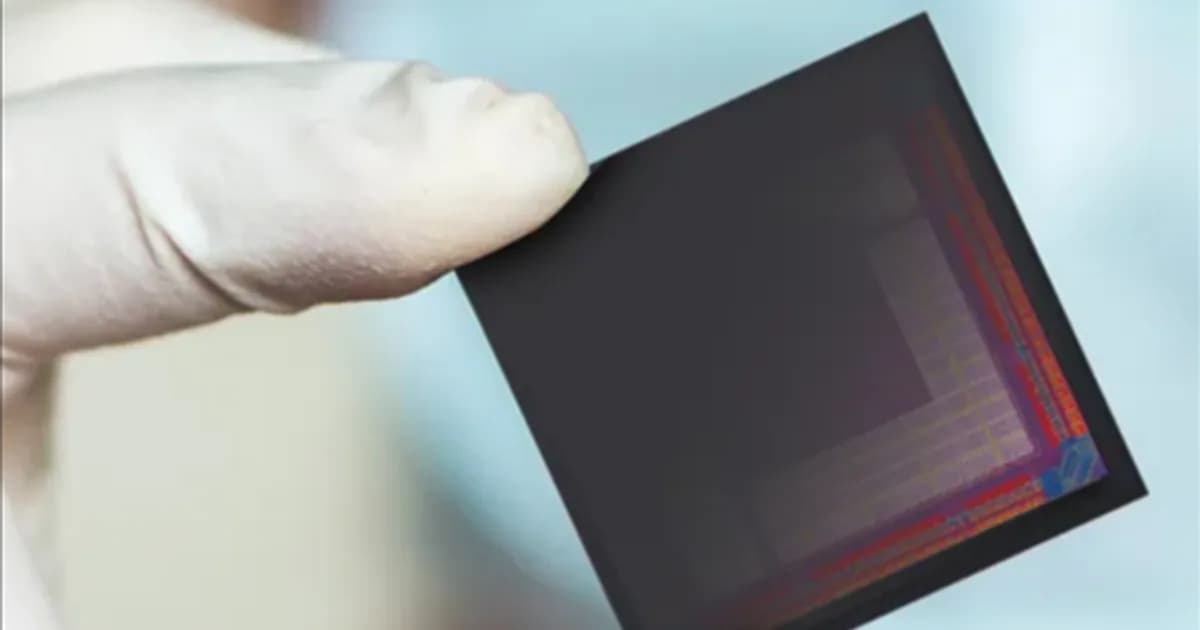
Ảnh render chính thức của chip Microsoft Maia 300 từ trang tin công bố của hãng

Kiến trúc đa chiplet trên tiến trình TSMC N2P tiên tiến

Điểm nhấn kỹ thuật lớn nhất của Maia 300 nằm ở kiến trúc đa chiplet (multi-chiplet) tiên tiến. Phần tính toán (compute) được đặt trên tiến trình TSMC N2P (phiên bản 2nm nâng cao), nơi mang lại lợi thế hiệu năng trên mỗi watt điện tốt nhất. Trong khi đó, các chức năng điều khiển bộ nhớ và I/O được tách riêng ra các die tối ưu cho băng thông, kết nối và chi phí, thường sử dụng tiến trình 3nm. Cách tiếp cận này cho phép tăng 36% số FLOPs tính toán của hệ thống, đồng thời tăng 2,5 lần băng thông HBM và cung cấp thêm 14% băng thông mở rộng quy mô (scale-up bandwidth). Bằng cách phân tách chức năng theo công nghệ phù hợp nhất, Microsoft tối đa hóa diện tích silicon dành cho hiệu năng tính toán thuần túy. Maia 300 tiếp tục phát triển kiến trúc SDLA (Software Defined Locally Accessed Dataflow Architecture) được giới thiệu từ Maia 200. Kiến trúc này tách biệt đường dẫn điều khiển và thực thi dữ liệu, cho phép phần mềm điều phối rõ ràng việc đặt, di chuyển, chuyển đổi và đồng bộ hóa dữ liệu giữa các bộ nhớ cục bộ, engine DMA, engine tính toán và mạng.
Sơ đồ kiến trúc hệ thống Azure Maia 300 với các chiplet và kết nối mạng

Hệ thống bộ nhớ HBM4: 288GB dung lượng và băng thông 18TB/s

Hệ thống bộ nhớ của Maia 300 được nâng cấp đáng kể với 8 stack HBM4, mang lại tổng dung lượng 288GB. So với thế hệ trước Maia 200 sử dụng 216GB HBM3, dung lượng đã tăng 33%. Quan trọng hơn, băng thông bộ nhớ đã tăng vọt từ 7,1TB/s lên 18TB/s, tương đương mức tăng 2,5 lần. Đối với suy luận mô hình ngôn ngữ lớn (LLM), bộ đệm KV (KV cache) và trọng số mô hình rất nhạy cảm với băng thông bộ nhớ. Dung lượng và băng thông lớn hơn trực tiếp quyết định hiệu quả suy luận trong các kịch bản ngữ cảnh dài. Maia 300 cung cấp khoảng 2 lần băng thông HBM trên mỗi watt so với Maia 200, giữ nhiều trạng thái mô hình và KV gần với bộ xử lý hơn. Kiến trúc bộ nhớ chuyển từ tổ chức truy cập bộ nhớ đồng nhất (UMA) sang tổ chức không đồng nhất nhận thức cục bộ (NUMA) giữa các chiplet. Mỗi vùng tính toán có bộ nhớ gần kề, và SDLA kiểm soát rõ ràng các engine DMA, SRAM cục bộ, HBM và mạng trên chip (NoC) để đặt dữ liệu ngay cạnh bộ xử lý sử dụng nó, giảm năng lượng tiêu thụ cho việc di chuyển dữ liệu.

Tối ưu hóa suy luận độ chính xác thấp và hiệu năng token

Maia 300 giới thiệu các định dạng độ chính xác thấp được cải thiện, bao gồm MXFP4 và các định dạng lưu trữ dưới 3-bit. Các biểu diễn hẹp hơn này làm giảm dấu chân bộ nhớ và di chuyển dữ liệu, cho phép hệ thống hỗ trợ các mô hình lớn hơn, ngữ cảnh dài hơn và nhiều phiên đồng thời hơn trong cùng một giới hạn năng lượng. Engine vector của Maia 300 được tối ưu hóa cho các kernel suy luận chính, bao gồm softmax, chuyển đổi dữ liệu độ chính xác thấp và các thao tác khác. Những cải tiến này giúp giảm số byte di chuyển cho mỗi token, tăng hiệu quả tổng thể của hệ thống. Microsoft cho biết Maia 300 dự kiến cung cấp 40% token trên mỗi megawatt nhiều hơn so với thế hệ trước. Ở quy mô rack trong trung tâm dữ liệu Microsoft, hệ thống Maia 300 dự kiến đạt hiệu suất token (token throughput) cao gấp 7 lần so với Maia 200, cho phép cung cấp phản hồi AI với khối lượng và tốc độ lớn hơn trên các dịch vụ đám mây.

Triển khai quy mô đa gigawatt và lợi thế cạnh tranh

Microsoft có kế hoạch mở rộng hệ thống Azure Maia lên các triển khai đa gigawatt bắt đầu từ năm 2027. Ở quy mô này, Maia 300 sẽ trở thành hệ thống suy luận AI chính, thay thế dần các giải pháp trước đó. Thiết kế rack của Maia 300 tích hợp 96 chip, với tổng dung lượng HBM đạt 27,6TB và băng thông tổng hợp khoảng 1,7PB/s. So sánh với các giải pháp cạnh tranh, Maia 300 thể hiện lợi thế về mật độ chip và hiệu quả năng lượng. Trong khi các hệ thống GPU khác có thể sử dụng 72 GPU với công suất khoảng 142kW, Maia 300 đạt mật độ chip gấp đôi và hiệu năng suy luận trên mỗi megawatt cao hơn khoảng 40%. Trong bối cảnh nhu cầu suy luận AI liên tục tiêu thụ chi phí tính toán, Microsoft đang sử dụng chip tự研 để đẩy hiệu quả đầu ra trên mỗi watt điện và mỗi đô la đầu tư lên mức giới hạn mới. Điều này giúp giảm chi phí vận hành cho các dịch vụ AI, làm cho các khả năng AI tiên tiến trở nên dễ tiếp cận, chi phí hợp lý và hữu ích hơn cho khách hàng.

Cộng đồng: