
GeForce Unlocked: Modders mở khóa hiệu năng tính toán RTX 20, 30 và 40 lên gấp đôi
Cộng đồng modders phát triển công cụ mở khóa giới hạn firmware của NVIDIA, giúp tăng gấp đôi hiệu năng tensor FP16/BF16 trên GPU GeForce RTX 20, 30 và 40 series.
Nvidia hạ băng thông HBM4 của Rubin từ 44TB/s xuống 38.5TB/s và NVLink từ 7.2TB/s xuống 6TB/s, nhưng nâng băng thông mạng lên 0.9TB/s nhằm tối ưu sản lượng HBM4.
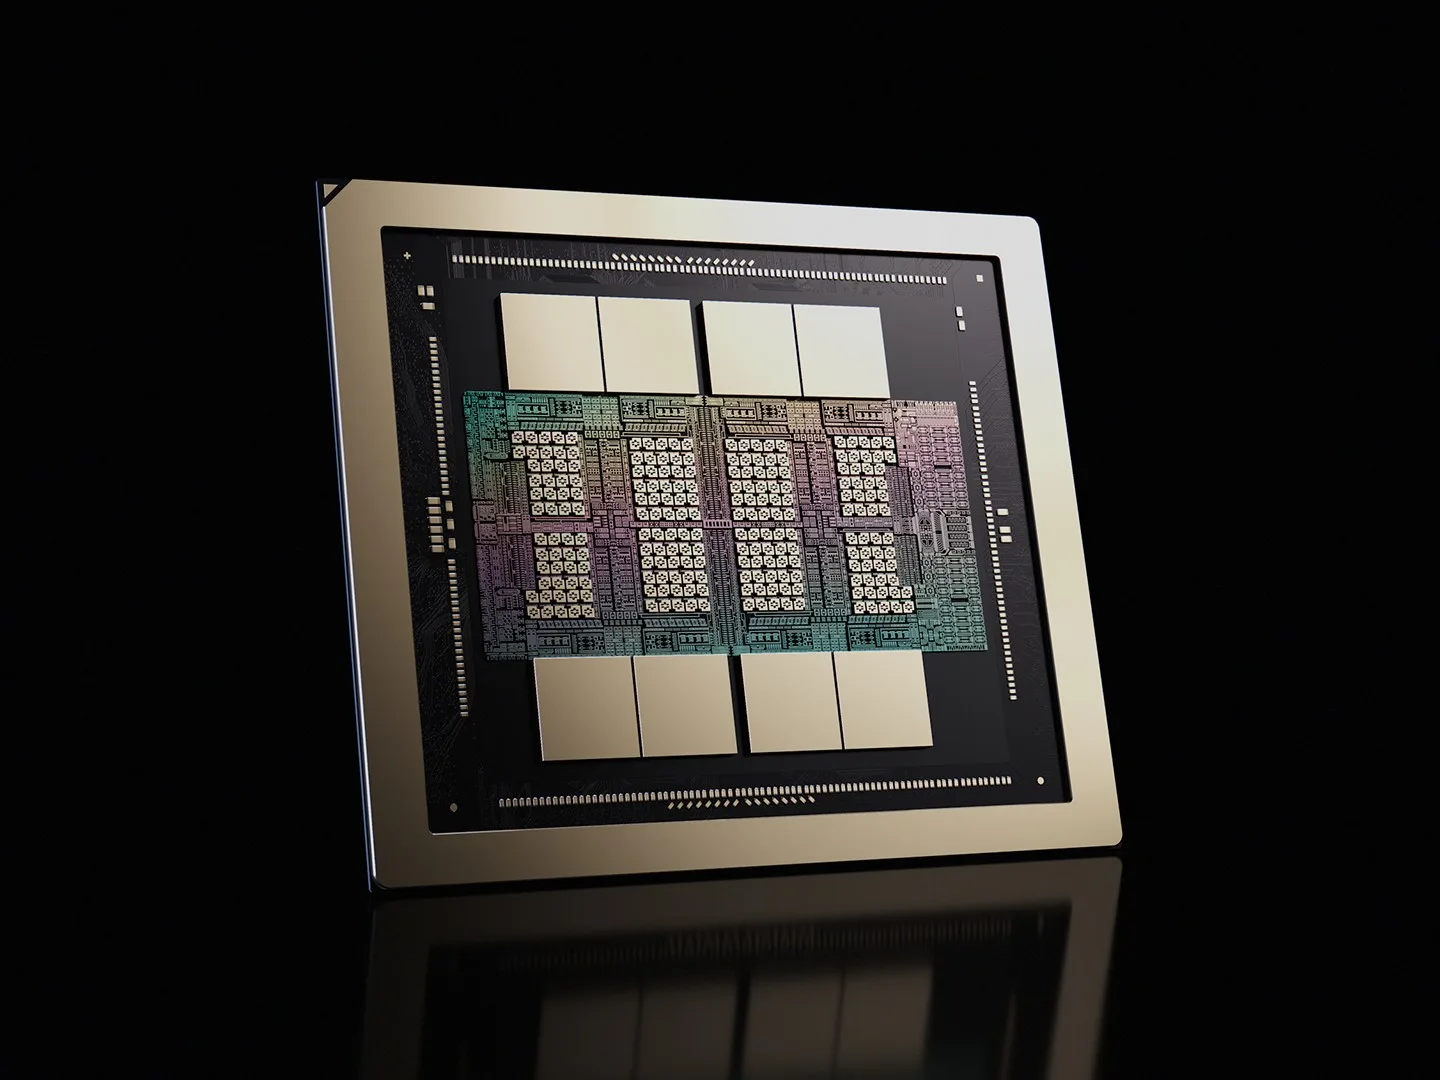
Dựa trên tài liệu kỹ thuật chính thức do Nvidia công bố trong tháng 10, các thông số băng thông của hệ thống GPU Rubin thế hệ mới đã có sự điều chỉnh đáng kể so với thử nghiệm từ tháng 6. Cụ thể, băng thông bộ nhớ HBM4 trên chip siêu Vera Rubin đã được hạ từ mức 44TB/s xuống còn 38.5TB/s. Đồng thời, băng thông liên kết NVLink cũng giảm từ 7.2TB/s xuống 6TB/s. Ngược lại, băng thông mạng mở rộng (scale-out network bandwidth) lại được tăng lên từ 0.8TB/s lên 0.9TB/s. Những thay đổi này phản ánh chiến lược tối ưu hóa cân bằng giữa bộ nhớ và kết nối mạng, nhằm đảm bảo hiệu năng tổng thể của hệ thống AI siêu quy mô. Sự điều chỉnh này áp dụng đồng bộ cho cả các cấu hình Vera Rubin NVL4 và Vera Rubin NVL72, trong đó băng thông mạng mở rộng của NVL4 thậm chí còn được nâng cao từ 0.4TB/s lên 1TB/s, cho thấy sự chú trọng đặc biệt vào khả năng giao tiếp giữa các node.
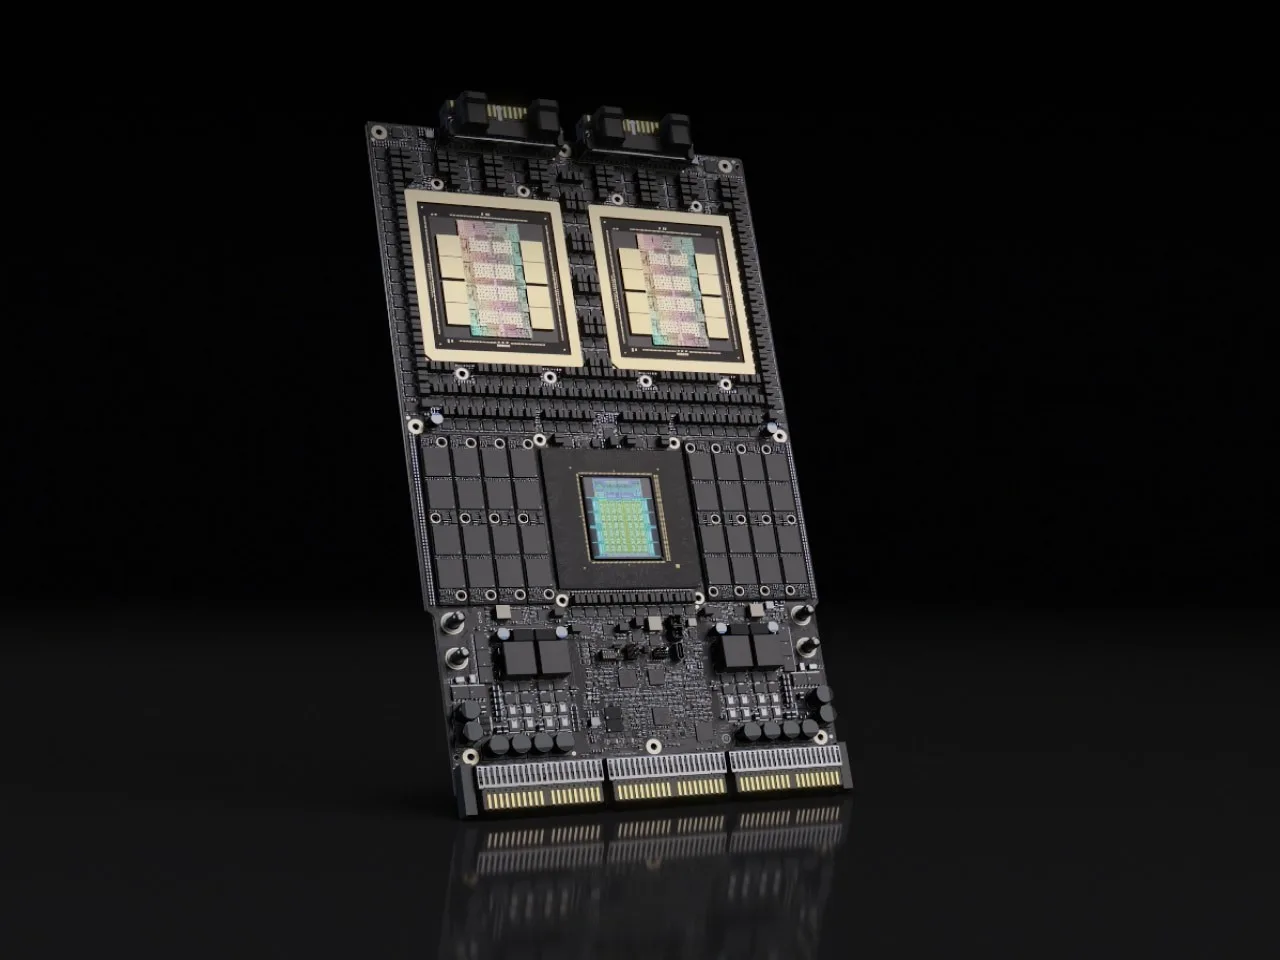
Đối với các giải pháp GPU Rubin dạng module SMX không phải chip siêu, hai hệ thống HGX NVL8 cũng trải qua những thay đổi tương tự. Dung lượng bộ nhớ HBM giảm từ 2.3TB xuống 2TB, trong khi băng thông bộ nhớ giảm mạnh từ 176TB/s xuống 130TB/s. Băng thông của NVLink Switch cũng được điều chỉnh giảm từ 28.8TB/s xuống 24TB/s. Tuy nhiên, băng thông mạng hai chiều (bidirectional network bandwidth) lại được tăng từ 1.6TB/s lên 1.8TB/s, giúp cải thiện khả năng truyền tải dữ liệu giữa các GPU trong cụm. Các chỉ số hiệu năng tính toán cho các định dạng số điểm động như NVFP4, FP8 và FP6 cũng được điều chỉnh giảm tương ứng, phản ánh sự thay đổi trong cấu trúc phần cứng và tối ưu hóa hiệu suất năng lượng.
Việc hạ thấp ngưỡng yêu cầu về băng thông HBM4 được xem là một bước đi chiến lược nhằm mở rộng nguồn cung linh kiện. Bằng cách giảm yêu cầu kỹ thuật từ 44TB/s xuống 38.5TB/s, Nvidia kỳ vọng nhiều hơn các nhà sản xuất bộ nhớ HBM4 sẽ đáp ứng được tiêu chuẩn kỹ thuật của Rubin GPU. Điều này trực tiếp góp phần tăng cường sản lượng cuối cùng của hệ thống, giúp Nvidia có thể giao hàng số lượng lớn hơn cho các trung tâm dữ liệu AI. Trong bối cảnh nhu cầu về bộ nhớ HBM4 đang ở mức căng thẳng, việc điều chỉnh thông số này là cần thiết để đảm bảo tiến độ sản xuất. Chiến lược này cũng giúp giảm áp lực lên chuỗi cung ứng HBM4, tạo điều kiện thuận lợi cho việc tích hợp bộ nhớ vào các hệ thống AI thế hệ mới mà không phải lo ngại về nguồn cung hạn chế.
Nguồn tổng hợp:
- ithome.com - 英伟达下调 Rubin GPU 系统 HBM 与 NVLink 带宽,网络带宽提升
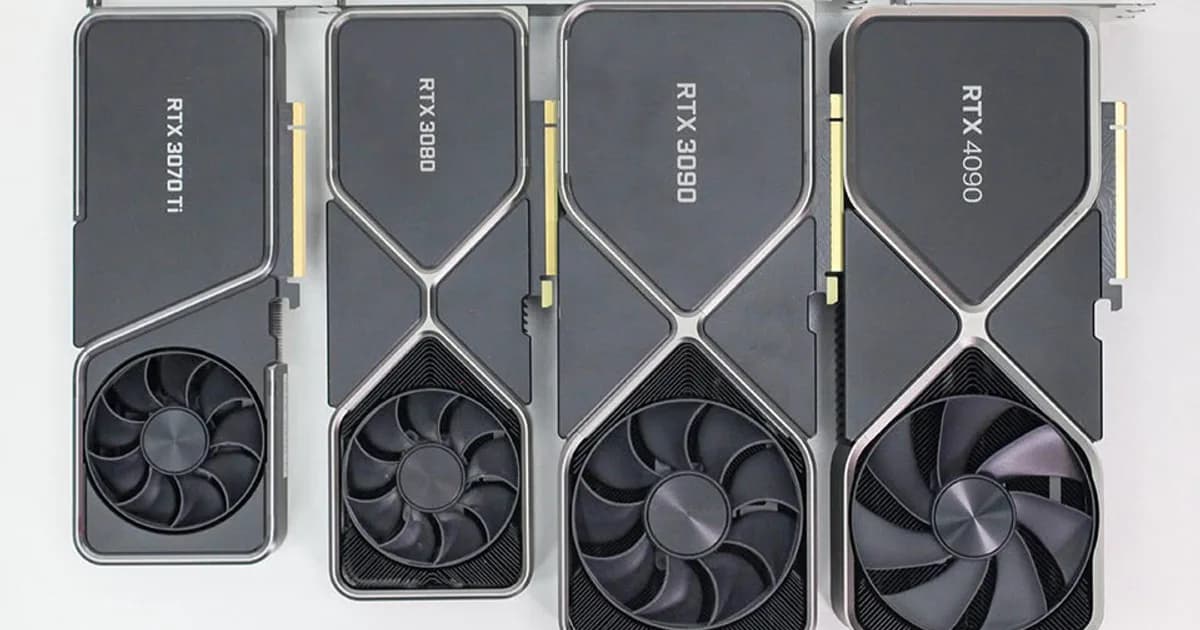
Cộng đồng modders phát triển công cụ mở khóa giới hạn firmware của NVIDIA, giúp tăng gấp đôi hiệu năng tensor FP16/BF16 trên GPU GeForce RTX 20, 30 và 40 series.
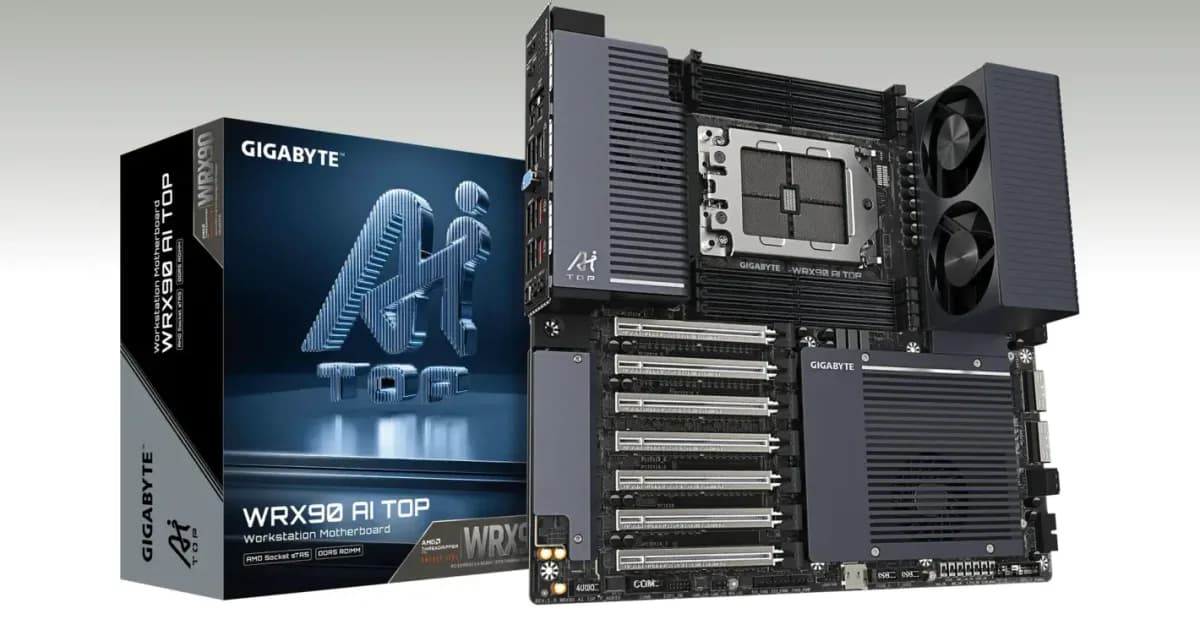
Gigabyte công bố bo mạch chủ WRX90 AI TOP cho AMD Threadripper PRO, hỗ trợ 2TB RAM ECC làm mát chủ động giảm 43 độ C và cấu hình tối đa 9 GPU.
OpenAI xác nhận GPT-5.6 Sol đã giúp phát hiện lỗ hổng PHP nghiêm trọng tồn tại 2 năm, ảnh hưởng đến 70% website. Các nhà nghiên cứu đã tạo exploit trong 2 tuần.
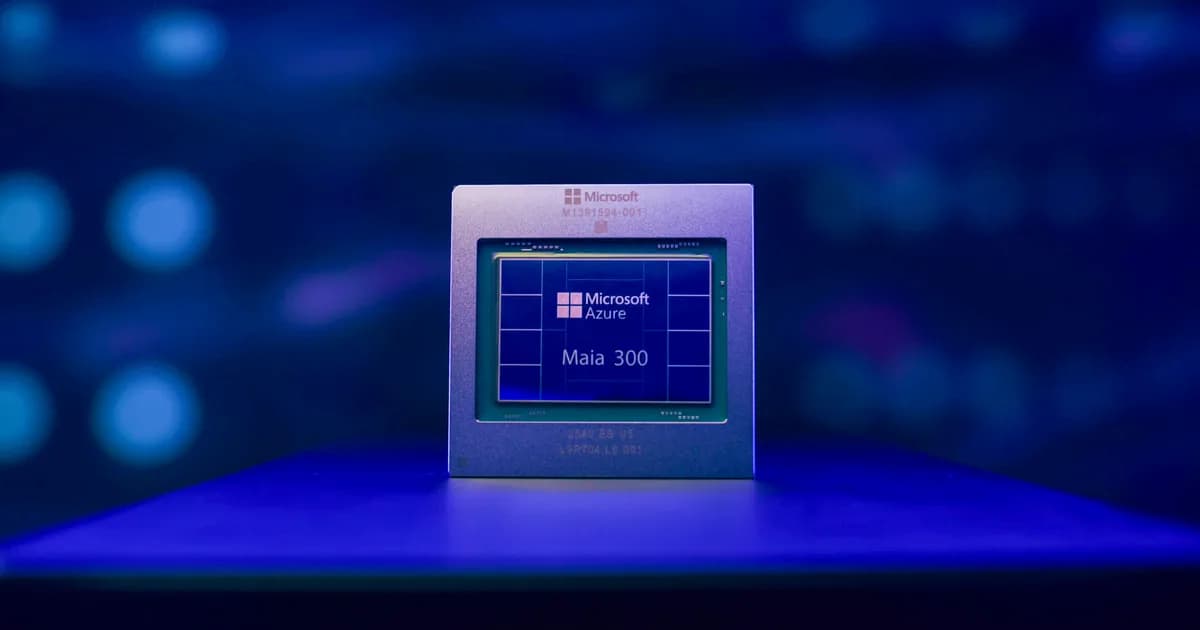
Microsoft công bố chip AI Maia 300 dùng tiến trình TSMC N2P, trang bị 288GB HBM4 với băng thông 18TB/s, dự kiến triển khai quy mô đa gigawatt từ 2027.
LTO Alliance công bố lộ trình LTO-14 với dung lượng 365TB, giảm nhẹ so với kế hoạch cũ để ưu tiên độ tin cậy. LTO-10 hiện đạt 40TB, duy trì vị thế lưu trữ lạnh hiệu quả.
TrendForce dự báo xuất khẩu CPU Server tăng 31% năm 2026 và hơn 40% năm 2027 nhờ AI Agents. Thị phần Arm dự kiến đạt 30% vào 2027, thách thức thế độc quyền của x86.
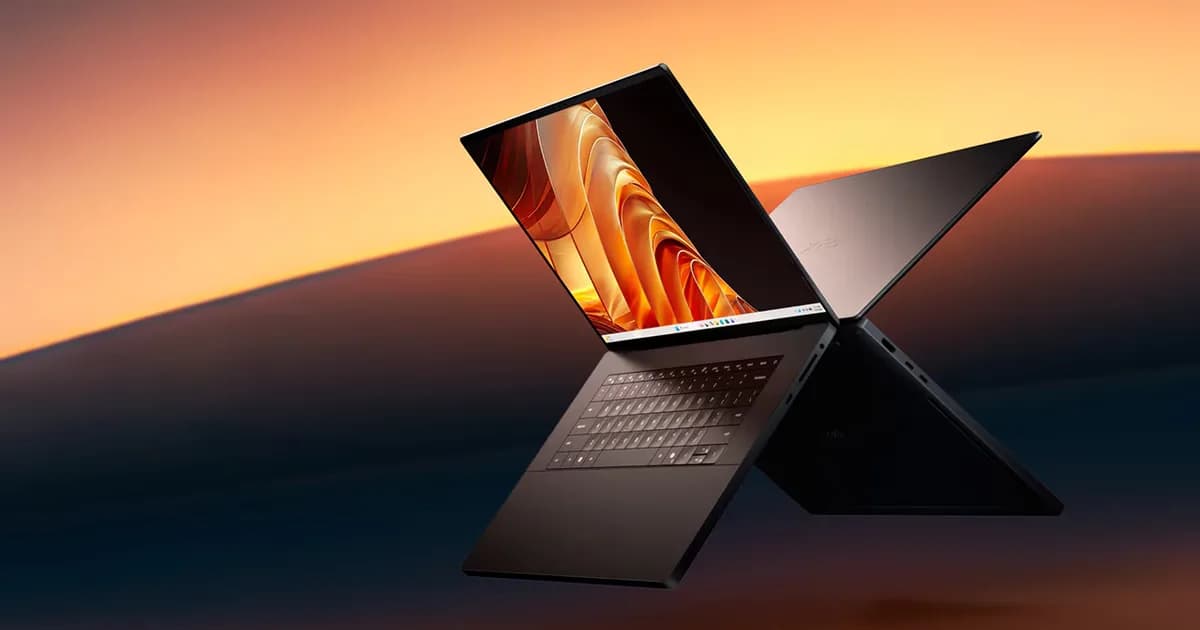
Dell chính thức bán XPS 16 Creator Edition toàn cầu với màn hình OLED 1.600 nits, chip NVIDIA RTX Spark N1X và tùy chọn RAM lên tới 128GB, khởi điểm 3.799 USD.
LattePanda Sigma 2 ra mắt với Intel Core Ultra X7 358H và GPU Arc B390, đạt 180 TOPS AI. Thiết kế 146x102mm tích hợp 2 cổng 10GbE và Thunderbolt 4 cho hệ thống nhúng.