Không có thông báo nào

Cuộc cách mạng phần cứng AI inference năm 2026: Vì sao GPU không còn là câu trả lời duy nhất?

Trong nhiều năm, cuộc đua AI chủ yếu xoay quanh việc đào tạo những mô hình ngày càng lớn. Các công ty công nghệ liên tục xây dựng siêu máy tính với hàng chục nghìn GPU để huấn luyện các mô hình có hàng trăm tỷ, thậm chí hàng nghìn tỷ tham số.

Trong nhiều năm, cuộc đua AI chủ yếu xoay quanh việc đào tạo những mô hình ngày càng lớn. Các công ty công nghệ liên tục xây dựng siêu máy tính với hàng chục nghìn GPU để huấn luyện các mô hình có hàng trăm tỷ, thậm chí hàng nghìn tỷ tham số.

Nhưng đến năm 2026, trọng tâm đang dịch chuyển. Khi AI ngày càng được sử dụng rộng rãi, đặc biệt với sự xuất hiện của các mô hình reasoning và AI agent, lượng tính toán cần thiết để chạy mô hình sau khi đã được huấn luyện – tức inference – đang tăng mạnh.

IEEE Spectrum nhận định sự thay đổi này đang tạo ra một cuộc cách mạng phần cứng mới. Vấn đề không còn đơn giản là làm chip có nhiều FLOPS hơn, mà là đưa dữ liệu tới bộ xử lý nhanh hơn, sử dụng bộ nhớ hiệu quả hơn và chia workload giữa nhiều loại chip khác nhau.

Inference khác training như thế nào?

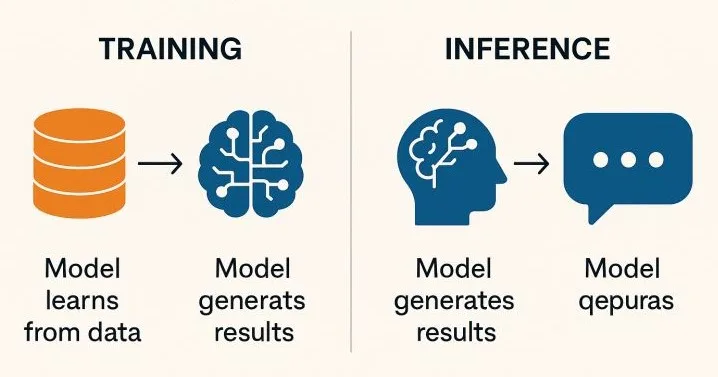
Training và inference sử dụng cùng một mô hình nhưng có đặc điểm tính toán rất khác nhau. Trong quá trình training, hệ thống liên tục điều chỉnh hàng tỷ hoặc hàng nghìn tỷ tham số thông qua backpropagation. Đây là loại workload có thể được chia nhỏ và xử lý song song ở quy mô rất lớn, khiến GPU trở thành kiến trúc phù hợp. Inference lại có một nút thắt khác. Khi người dùng gửi một câu hỏi, mô hình trước tiên phải xử lý toàn bộ prompt. Giai đoạn này được gọi là prefill. Sau đó, mô hình tạo câu trả lời từng token một, được gọi là decode. Prefill có thể xử lý song song tương đối hiệu quả. Decode thì khác: mỗi token mới phụ thuộc vào token trước đó và toàn bộ ngữ cảnh đã được tạo ra. Mỗi bước có thể phải đọc lượng lớn trọng số của mô hình cùng với KV cache, nơi lưu thông tin về ngữ cảnh trước đó. Khi cuộc hội thoại dài hoặc AI agent liên tục thực hiện nhiều bước suy luận, KV cache có thể tăng lên hàng chục GB. Điều này dẫn đến một nghịch lý: một GPU rất mạnh về tính toán có thể vẫn phải chờ dữ liệu từ bộ nhớ. Theo IEEE Spectrum, nghiên cứu cho thấy GPU Nvidia H100 khi chạy một số LLM mã nguồn mở có thể ở trạng thái chờ tới 50–80% thời gian. Vấn đề vì thế không chỉ nằm ở năng lực tính toán mà còn ở memory bandwidth và data movement.

Inference - training

Cuộc đua mới tập trung vào bộ nhớ

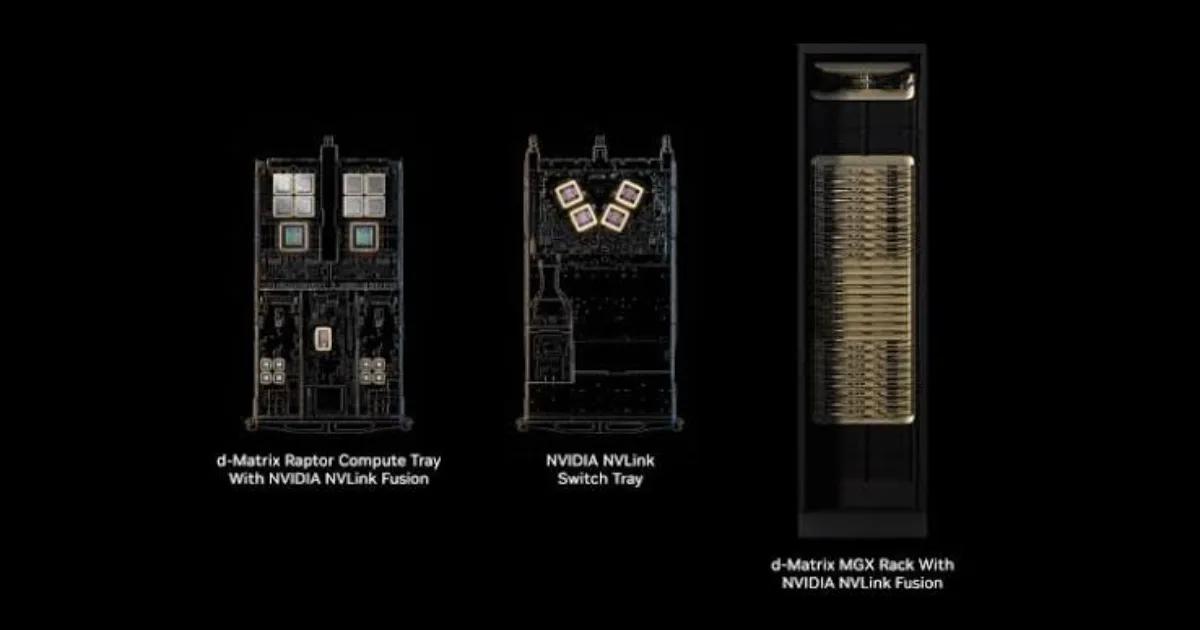
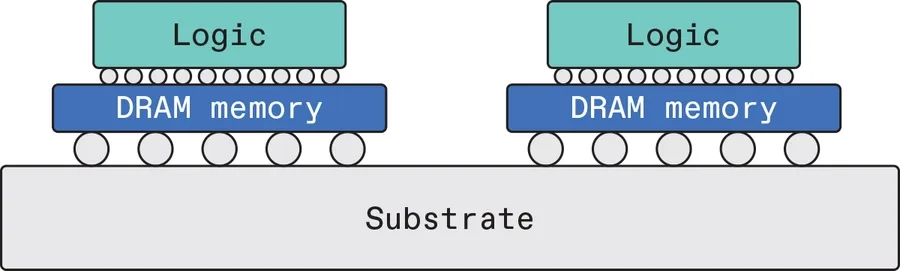
Một hướng tiếp cận là đưa bộ nhớ và phần tính toán lại gần nhau hơn. Startup d-Matrix đang phát triển Raptor theo hướng này. Thay vì đặt HBM xung quanh bộ xử lý như cách GPU hiện nay thường làm, Raptor xếp chồng trực tiếp bộ xử lý AI lên DRAM. Theo CEO Sudeep Bhoja, cách thiết kế này có thể giảm khoảng cách truyền dữ liệu từ mức milimet xuống micromet, qua đó tăng đáng kể băng thông giữa bộ nhớ và phần tính toán. Một công ty khác là Majestic Labs lại chọn hướng ngược lại. Thay vì đưa bộ nhớ sát với chip hơn, công ty phát triển một giao diện bộ nhớ có thể duy trì băng thông cao ngay cả khi khoảng cách giữa chip xử lý và các module DRAM lớn hơn. Majestic cho biết công nghệ của họ có thể truyền dữ liệu qua khoảng cách tới 1 mét, cho phép kết nối nhiều DRAM phổ thông và đưa tổng dung lượng bộ nhớ của một rack lên tới 128 TB. Con số này lớn hơn nhiều so với khoảng 20 TB HBM3E trong một rack Nvidia GB300 NVL72. Một lý do khiến các startup quan tâm tới DRAM là chi phí: theo nhà phân tích Jim Handy, HBM có giá cao hơn khoảng 2–3 lần so với DRAM thông thường. Trong khi đó, ngành HBM cũng không đứng yên. HBM4 đã bước vào sản xuất và dự kiến được sử dụng trong GPU Vera Rubin của Nvidia. SK Hynix cho rằng thế hệ HBM mới sẽ tăng đáng kể băng thông và dung lượng bộ nhớ trên mỗi stack, nhằm giải quyết một phần những hạn chế hiện nay của inference.

d-Matrix

Nvidia và AWS bắt đầu chia inference thành nhiều loại chip

Một xu hướng khác đang nổi lên là inference disaggregation – tách các giai đoạn khác nhau của inference cho những loại chip phù hợp nhất. Nvidia đang kết hợp GPU Vera Rubin với Groq 3 LPU, bộ xử lý được thiết kế đặc biệt cho việc tạo token với độ trễ thấp. Groq 3 sử dụng tới 500 MB SRAM tích hợp trực tiếp trên chip. Dung lượng này nhỏ hơn rất nhiều so với HBM trên GPU Rubin, nhưng đổi lại LPU đạt băng thông bộ nhớ khoảng 150 TB/s, cao hơn khoảng 7 lần con số 22 TB/s được IEEE Spectrum nêu cho Rubin GPU. Ý tưởng là để Rubin xử lý phần prefill và các phép tính cần nhiều năng lực tính toán, trong khi Groq 3 đảm nhiệm phần decode phụ thuộc nhiều vào tốc độ truy cập bộ nhớ. Nvidia dự kiến đặt 256 LPU trong hệ thống Groq 3 LPX, hoạt động cùng rack Vera Rubin NVL72. AWS cũng đang đi theo hướng tương tự khi kết hợp Trainium với chip wafer-scale Cerebras WSE-3. Trainium đảm nhiệm phần prefill có tính song song cao, trong khi Cerebras xử lý decode với hệ thống SRAM khổng lồ tích hợp trên wafer. WSE-3 có 44 GB SRAM và hơn 4 nghìn tỷ transistor. Cách tiếp cận này cho thấy tương lai inference có thể không phải là một chip duy nhất làm tất cả. Thay vào đó, một hệ thống AI có thể sử dụng nhiều loại bộ xử lý, mỗi loại tối ưu cho một giai đoạn khác nhau.

Không chỉ phần cứng: AI đang được nén xuống 4-bit

Phần cứng không phải cách duy nhất để giảm chi phí inference. Các nhà nghiên cứu cũng đang tìm cách làm cho chính mô hình AI nhẹ hơn mà không mất quá nhiều chất lượng. Một kỹ thuật quan trọng là quantization, tức giảm độ chính xác của các con số được sử dụng để biểu diễn trọng số mô hình. Nvidia đang thúc đẩy định dạng NVFP4, trong khi AMD, Intel và Qualcomm cùng hỗ trợ MXFP4. Khi giảm từ 8-bit xuống 4-bit, lượng dữ liệu cần lưu trữ và truyền tải giảm đáng kể. Nvidia cho biết khi lượng tử hóa DeepSeek-R1 từ FP8 xuống NVFP4, điểm số trên 7 benchmark lớn giảm chưa tới 1%, trong khi hiệu năng tăng khoảng 3 lần. Đây là con số do Nvidia công bố và cần được xem xét trong bối cảnh benchmark cụ thể. Các startup cũng đang thử nghiệm những hướng đi khác thường hơn. Tensordyne phát triển chip Napier sử dụng hệ thống biểu diễn số logarithmic, nhằm thay thế một số phép nhân bằng phép cộng – loại phép toán có thể được thực hiện với chi phí phần cứng và năng lượng thấp hơn. Trong khi đó, Etched đang xây dựng ASIC được tối ưu trực tiếp cho kiến trúc Transformer. Cách làm này có thể đạt hiệu năng rất cao đối với các mô hình phù hợp, nhưng đổi lại chip sẽ kém linh hoạt hơn nếu kiến trúc AI trong tương lai thay đổi đáng kể.

AI inference có thể tạo ra một thị trường chip hoàn toàn mới

Điểm đáng chú ý nhất từ bức tranh mà IEEE Spectrum đưa ra là không có một hướng tiếp cận duy nhất đang giải quyết bài toán inference. Có công ty tập trung vào SRAM. Có công ty đưa compute trực tiếp lên DRAM. Có công ty kéo dài khoảng cách giữa chip và bộ nhớ để sử dụng nhiều DRAM hơn. Nvidia và AWS lại chia workload giữa nhiều loại accelerator. Các nhà nghiên cứu khác tìm cách giảm số bit hoặc thay đổi hoàn toàn cách thực hiện phép toán. Sự đa dạng này xuất phát từ một thay đổi căn bản: AI hiện không còn chỉ cần được huấn luyện nhanh, mà phải được chạy liên tục ở quy mô khổng lồ. Các mô hình reasoning có thể thực hiện nhiều vòng suy luận cho một câu hỏi. AI agent có thể hoạt động hàng giờ hoặc cả ngày để hoàn thành mục tiêu thay vì chỉ trả lời một câu hỏi. Điều đó khiến tổng lượng inference có thể tiếp tục tăng ngay cả khi tốc độ phát triển của các mô hình nền chậm lại. Vì vậy, cuộc cạnh tranh phần cứng AI trong những năm tới có thể không chỉ là Nvidia so với AMD hay một GPU so với GPU khác. Nó có thể trở thành cuộc đua giữa GPU, LPU, ASIC, wafer-scale processor, các kiến trúc memory-centric và những hệ thống kết hợp nhiều loại chip. Nói cách khác, kỷ nguyên tiếp theo của AI có thể không được quyết định bởi việc ai sở hữu chip mạnh nhất, mà bởi việc ai xây dựng được hệ thống xử lý inference hiệu quả nhất trên mỗi watt, mỗi GB bộ nhớ và mỗi token được tạo ra.

Nguồn: spectrum.ieee
Cộng đồng: