Không có thông báo nào

d-Matrix đưa chip AI Raptor vào hệ sinh thái NVIDIA NVLink Fusion

d-Matrix, công ty phát triển chip AI chuyên cho suy luận (inference), vừa công bố hợp tác với NVIDIA để đưa thế hệ XPU tiếp theo của mình vào nền tảng NVLink Fusion. Động thái này cho phép d-Matrix tận dụng kiến trúc rack-scale và hệ thống kết nối tốc độ cao của NVIDIA để mở rộng các cụm chip suy luận mà không phải tự xây dựng toàn bộ hạ tầng từ đầu.

d-Matrix, công ty phát triển chip AI chuyên cho suy luận (inference), vừa công bố hợp tác với NVIDIA để đưa thế hệ XPU tiếp theo của mình vào nền tảng NVLink Fusion. Động thái này cho phép d-Matrix tận dụng kiến trúc rack-scale và hệ thống kết nối tốc độ cao của NVIDIA để mở rộng các cụm chip suy luận mà không phải tự xây dựng toàn bộ hạ tầng từ đầu.


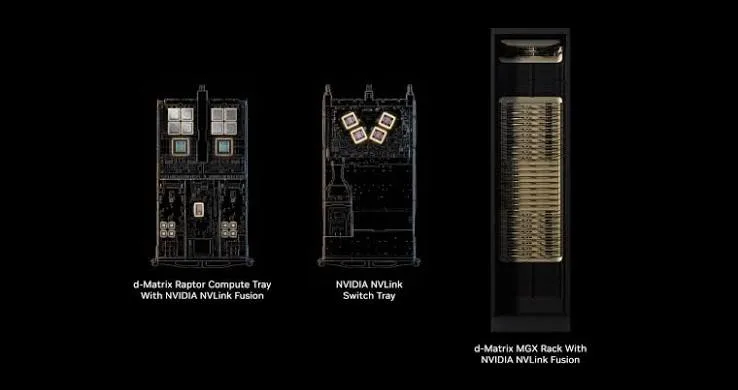
Theo kế hoạch, thế hệ XPU Raptor của d-Matrix sẽ được tích hợp vào kiến trúc rack NVIDIA MGX, kết hợp với nhiều thành phần trong hệ sinh thái NVIDIA như CPU Vera, NVLink Switch, BlueField-4 DPU, ConnectX-9 SuperNIC và mạng Ethernet Spectrum-X. Các hệ thống Raptor đầu tiên tích hợp vào rack NVIDIA MGX dự kiến có mặt vào quý IV/2027.

NVLink Fusion mở đường cho chip AI bên thứ ba

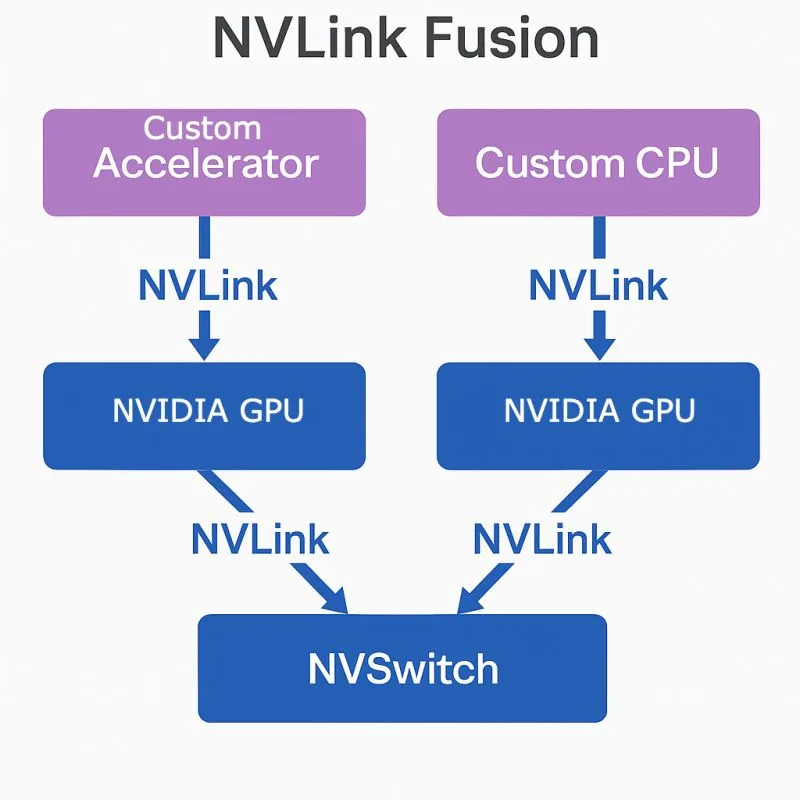
NVLink vốn là công nghệ kết nối tốc độ cao của NVIDIA, được sử dụng để liên kết các GPU và thành phần tính toán trong những hệ thống AI quy mô lớn. Với NVLink Fusion, NVIDIA mở rộng nền tảng này cho các công ty phát triển chip tùy biến, cho phép XPU hoặc CPU bên thứ ba kết nối vào hạ tầng rack-scale của NVIDIA. Điều này giải quyết một vấn đề lớn đối với các startup chip AI: thiết kế được một bộ xử lý nhanh mới chỉ là bước đầu. Để đưa sản phẩm vào các trung tâm dữ liệu quy mô lớn, doanh nghiệp còn phải xây dựng hệ thống kết nối, rack, nguồn điện, làm mát, quản lý hệ thống, chuỗi cung ứng và các thành phần mạng tương thích. d-Matrix có thể bỏ qua phần lớn công việc này bằng cách dựa trên hệ sinh thái MGX và NVLink Fusion đã được NVIDIA xây dựng. Theo NVIDIA, cách tiếp cận này giúp các nhà phát triển chip rút ngắn thời gian đưa sản phẩm ra thị trường và giảm rủi ro khi triển khai ở quy mô lớn. Với d-Matrix, Raptor sẽ kết nối vào miền scale-up băng thông cao, độ trễ thấp thông qua NVLink. Công ty cũng sử dụng các thành phần mạng và hạ tầng của NVIDIA thay vì phải phát triển một kiến trúc rack hoàn toàn riêng biệt.

Raptor tập trung vào suy luận AI độ trễ thấp

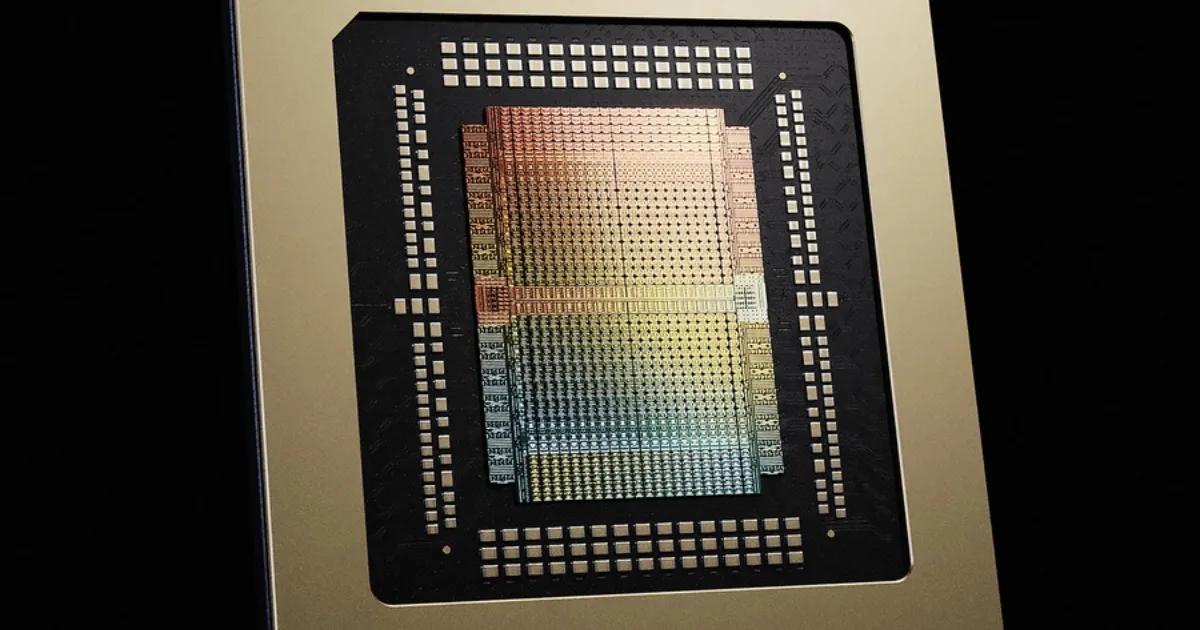
Raptor là thế hệ XPU tiếp theo của d-Matrix, được thiết kế chủ yếu cho AI inference, đặc biệt là những workload yêu cầu phản hồi nhanh. Khác với GPU đa dụng, d-Matrix theo đuổi kiến trúc memory-centric computing, đưa bộ nhớ đến gần các thành phần tính toán hơn nhằm giảm độ trễ và chi phí di chuyển dữ liệu. Raptor tiếp tục hướng đi này bằng công nghệ 3D DRAM stacking, kết hợp một chip DRAM và một chip SRAM chứa phần tính toán thành một package dạng “hai tầng”. Kiến trúc này hướng tới những ứng dụng mà tốc độ phản hồi của từng token có ý nghĩa lớn, chẳng hạn trợ lý lập trình AI, chatbot thời gian thực và voice agent. Một điểm đáng chú ý là d-Matrix không định vị Raptor như một sản phẩm thay thế hoàn toàn GPU NVIDIA. Thay vào đó, hai loại chip có thể đảm nhiệm những phần khác nhau trong cùng một pipeline suy luận. Ví dụ với AI coding, GPU có thể xử lý prefill – giai đoạn cần lượng tính toán lớn để xử lý prompt và context – trong khi XPU của d-Matrix đảm nhiệm decode, nơi độ trễ của từng token có ảnh hưởng trực tiếp tới cảm giác phản hồi của người dùng. Mô hình này được gọi là heterogeneous disaggregation, tức phân tách workload giữa các kiến trúc phần cứng khác nhau.

XPU d-Matrix

NVIDIA cũng hưởng lợi khi mở NVLink cho XPU bên ngoài

Đối với d-Matrix, lợi ích khá rõ: công ty có thể đưa Raptor vào một nền tảng rack đã được chuẩn hóa thay vì phải tự phát triển toàn bộ hệ thống. Nhưng NVIDIA cũng có động lực mạnh để mở rộng NVLink Fusion. Khi các startup và hyperscaler sử dụng XPU riêng, NVIDIA vẫn có thể cung cấp những lớp hạ tầng quan trọng như NVLink, MGX, CPU Vera, networking, DPU và switching. ServeTheHome nhận xét rằng nếu d-Matrix giành được khách hàng cho XPU của mình, NVIDIA vẫn có thể hưởng lợi từ việc cung cấp các thành phần kết nối và CPU nằm bên trong hệ thống triển khai đó. Đây là một thay đổi đáng chú ý trong chiến lược hạ tầng AI của NVIDIA. Công ty không chỉ muốn các trung tâm dữ liệu sử dụng GPU NVIDIA mà còn đang xây dựng một nền tảng cho phép nhiều loại bộ xử lý khác nhau cùng tồn tại trong một AI factory. NVLink Fusion hiện được định hướng cho các hyperscaler, công ty AI và nhà phát triển silicon tùy biến. NVIDIA cho biết nền tảng này hỗ trợ CPU theo các kiến trúc Arm, x86 và RISC-V, đồng thời mở rộng NVLink từ kết nối GPU NVIDIA sang các XPU và CPU bên thứ ba. Với d-Matrix, việc Raptor được thiết kế ngay từ đầu để tích hợp vào NVLink Fusion và MGX cho thấy công ty đang lựa chọn hướng đi bổ sung cho hệ sinh thái NVIDIA thay vì đối đầu trực diện với GPU NVIDIA. Nếu Raptor đạt được mục tiêu về độ trễ và hiệu suất năng lượng, mô hình này có thể trở thành một ví dụ cho xu hướng mới của trung tâm dữ liệu AI: thay vì một loại chip xử lý toàn bộ workload, các hệ thống sẽ kết hợp GPU, XPU, CPU và các bộ xử lý chuyên dụng, mỗi loại đảm nhiệm phần công việc mà nó có lợi thế nhất.
Nguồn: servethehome

Cộng đồng: