Không có thông báo nào

GPT-6 Astra được đưa vào robot, Tsinghua và đối tác Trung Quốc mở mã nguồn R​​Pent

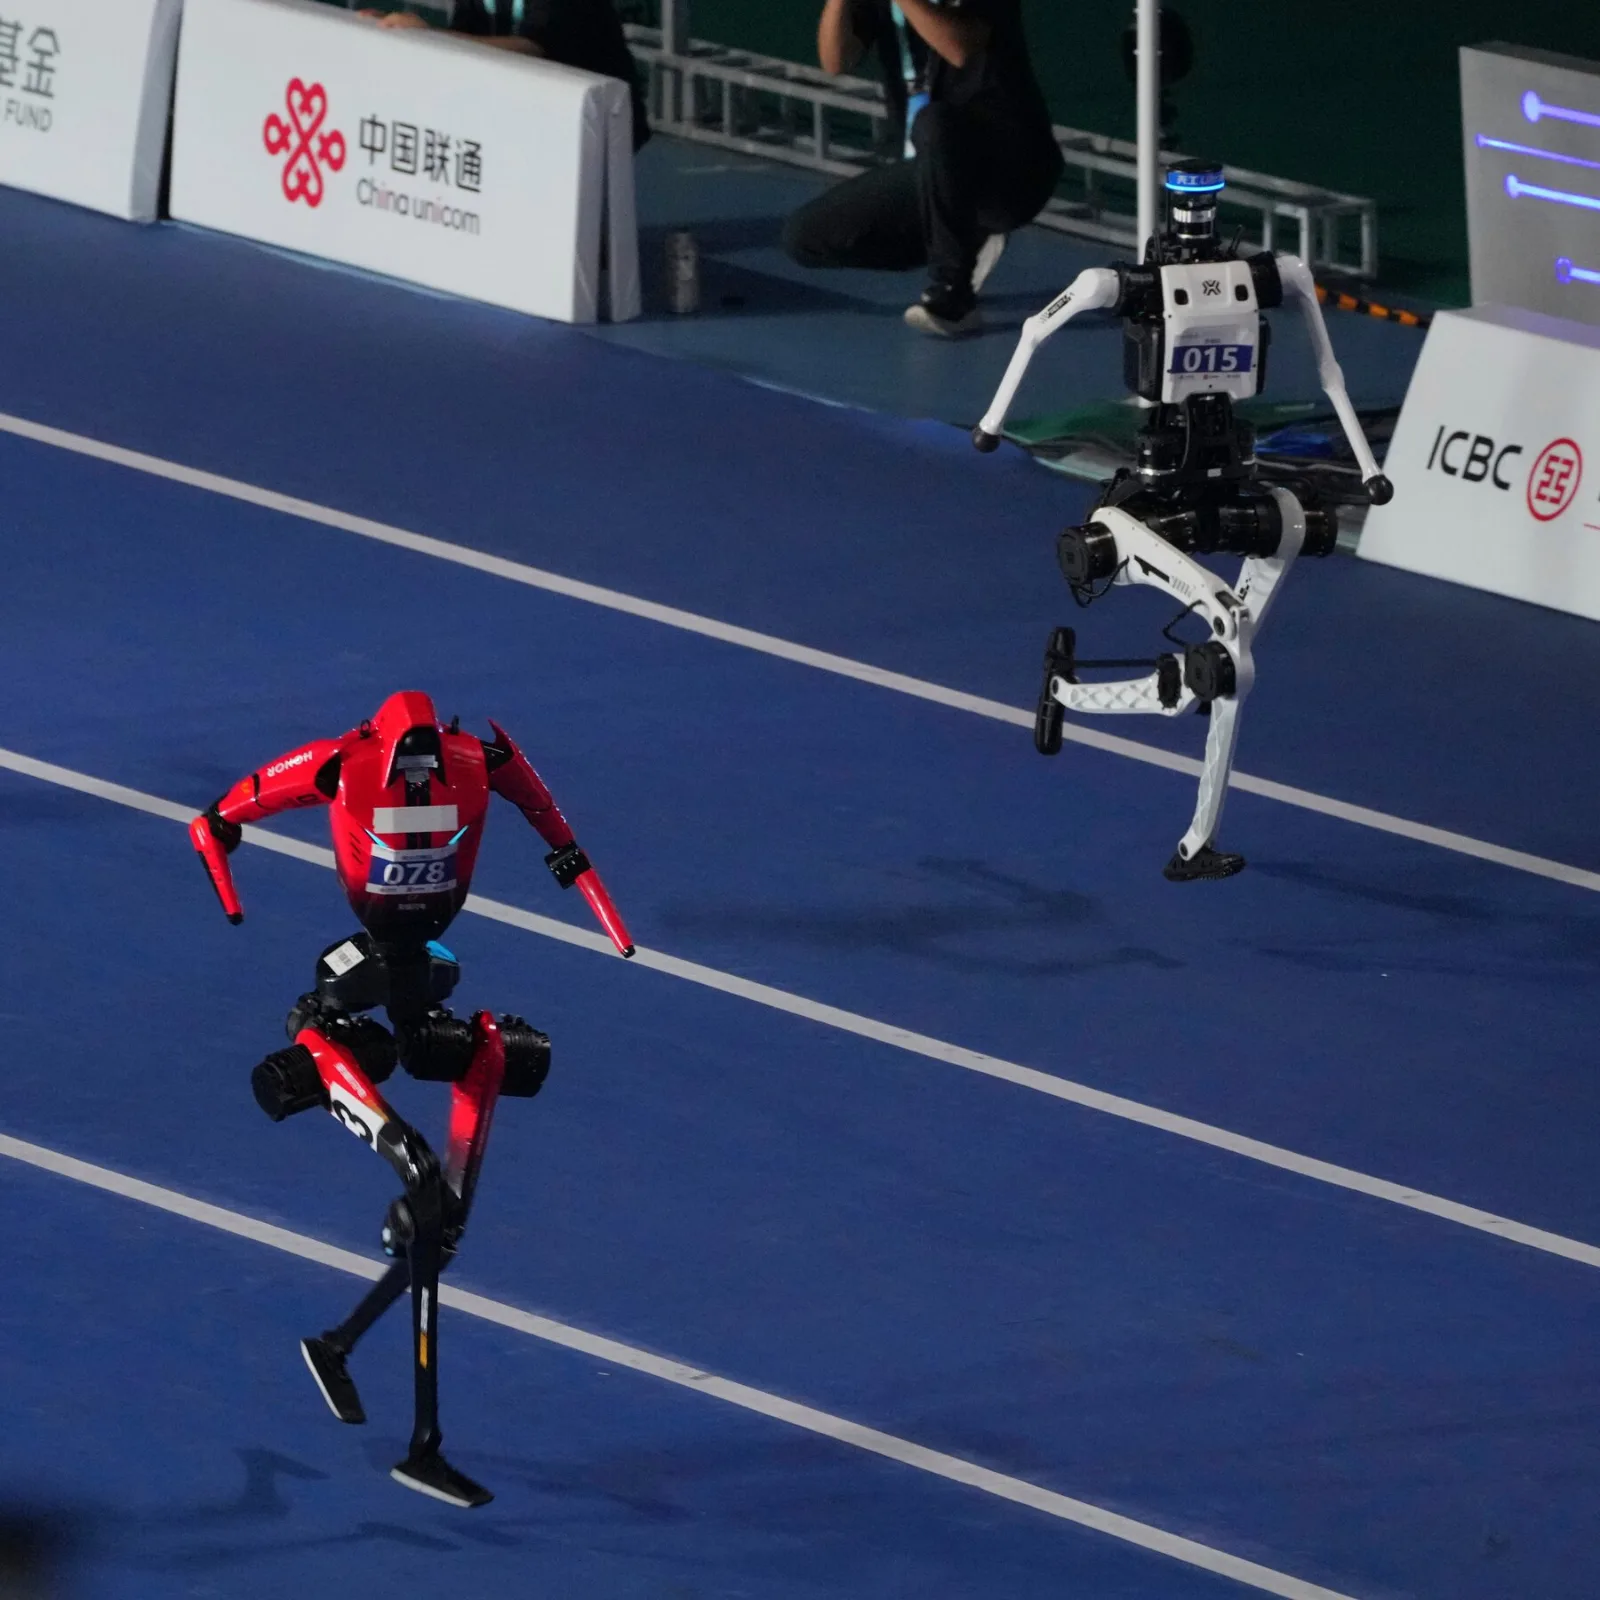
Các mô hình AI đang bắt đầu chuyển từ việc xử lý tác vụ trong môi trường số sang trực tiếp điều khiển robot trong thế giới thực. Một ví dụ mới đến từ Đại học Thanh Hoa (Tsinghua University), 无问芯穹 và 正行创新, khi các bên vừa công bố mã nguồn mở RPent, một nền tảng dành cho xây dựng tác tử AI có khả năng tương tác với robot và môi trường vật lý.

Các mô hình AI đang bắt đầu chuyển từ việc xử lý tác vụ trong môi trường số sang trực tiếp điều khiển robot trong thế giới thực. Một ví dụ mới đến từ Đại học Thanh Hoa (Tsinghua University), 无问芯穹 và 正行创新, khi các bên vừa công bố mã nguồn mở RPent, một nền tảng dành cho xây dựng tác tử AI có khả năng tương tác với robot và môi trường vật lý.

Đáng chú ý, R​​Pent đã được sử dụng để thử nghiệm GPT-6 Astra trên robot thực tế. Thay vì để một mô hình duy nhất đảm nhiệm toàn bộ quá trình từ hiểu yêu cầu đến điều khiển từng chuyển động, R​​Pent chia hệ thống thành nhiều lớp, kết hợp mô hình ngôn ngữ lớn, VLA, công cụ, bộ nhớ và giao diện robot.

Theo nhóm phát triển, hệ thống đạt 92,6% tỷ lệ hoàn thành nhiệm vụ trên benchmark LIBERO-Pro, đồng thời có thể giảm thời gian thực hiện nhiệm vụ hơn 7 lần nhờ cơ chế tái sử dụng kinh nghiệm.

R​​Pent biến robot thành một AI agent thay vì chỉ chạy chuỗi động tác cố định

Robot truyền thống thường được huấn luyện hoặc lập trình để thực hiện một nhóm thao tác tương đối cố định. Khi mục tiêu, vị trí vật thể hoặc môi trường thay đổi, robot có thể không biết cách thích nghi. R​​Pent theo đuổi cách tiếp cận khác. Hệ thống để mô hình AI cấp cao hiểu mục tiêu và lập kế hoạch, sau đó gọi những năng lực chuyên biệt để thực hiện các thao tác chính xác. Kiến trúc này kết hợp foundation model, VLA (Vision-Language-Action), Memory và Tool Library. Mô hình ngôn ngữ đảm nhiệm việc hiểu nhiệm vụ và lập kế hoạch, trong khi các mô hình chuyên biệt chịu trách nhiệm thực hiện những hành động vật lý có yêu cầu độ chính xác cao. Trong các video trình diễn, robot có thể thực hiện những nhiệm vụ mở như đổ viên bi vào bát, dùng hai tay lau đĩa hoặc chủ động di chuyển vật cản để tìm chiếc thìa bị che khuất. Điểm đáng chú ý không nằm ở từng động tác riêng lẻ mà ở cách robot quan sát → lập kế hoạch → hành động → kiểm tra kết quả → điều chỉnh. Ví dụ, khi được yêu cầu đặt bộ đồ ăn sạch vào thùng giấy, robot có thể nhận ra rằng vị trí mục tiêu hiện tại khác với dữ liệu đã học trước đó và thay đổi hành động thay vì đơn giản lặp lại một chuỗi động tác cũ. Trong một nhiệm vụ khác, robot cần đọc nhãn trên chai và túi để phân loại đồ uống. Khi đường di chuyển ban đầu không còn phù hợp, hệ thống có thể điều chỉnh tư thế cổ tay. Khi chiếc thìa bị hai chiếc bát che khuất, robot trước tiên di chuyển bát sang vị trí khác để khiến mục tiêu trở nên dễ quan sát và tiếp cận hơn. Đây là khác biệt quan trọng giữa “robot thực hiện kỹ năng đã học” và “AI agent sử dụng các kỹ năng để giải quyết mục tiêu mới”.

GPT-6 Astra

Memory và Flash Mode giúp robot không phải suy nghĩ lại từ đầu

Một trong những vấn đề lớn khi đưa các mô hình ngôn ngữ vào robot là độ trễ. Mô hình có thể mất nhiều thời gian để suy luận, trong khi robot cần phản ứng nhanh với những thay đổi trong môi trường. R​​Pent giải quyết vấn đề này bằng cách lưu lại những nhiệm vụ đã được khám phá và xác nhận thành Task Card. Task Card không lưu một chuỗi tọa độ cứng nhắc mà ghi lại logic thực hiện nhiệm vụ, các hành động cần gọi và điều kiện kiểm tra. Khi gặp một nhiệm vụ tương tự, hệ thống có thể sử dụng lại kinh nghiệm đó và chỉ điều chỉnh những phần phụ thuộc vào trạng thái hiện tại của môi trường. Cơ chế này được gọi là Flash Mode. Theo kết quả được công bố, trong 200 lần đánh giá trên LIBERO Object, Flash Mode giảm thời gian thực hiện trung bình từ 283,6 giây xuống còn 40,9 giây. Tỷ lệ thành công giảm khoảng 3,5 điểm phần trăm, nhưng thời gian hoàn thành giảm khoảng 7 lần. Điều này cho phép hệ thống tránh việc gọi mô hình AI lớn để lập kế hoạch lại ở mọi bước. Khi môi trường vẫn tương đối ổn định, robot có thể sử dụng kinh nghiệm đã được xác nhận; chỉ khi kết quả kiểm tra thất bại hoặc môi trường thay đổi đáng kể, hệ thống mới quay lại gọi bộ lập kế hoạch. R​​Pent cũng xây dựng hệ thống Memory theo nhiều cấp độ, trong đó kinh nghiệm được gắn với phạm vi áp dụng, loại nhiệm vụ, độ tin cậy và bằng chứng hỗ trợ. Những kinh nghiệm chưa được xác nhận không được mặc định coi là kiến thức đáng tin cậy. Cách tiếp cận này hướng tới một mô hình trong đó mỗi lần robot giải quyết thành công một nhiệm vụ có thể tạo ra tài sản kiến thức cho những lần thực hiện tiếp theo.

GPT-6 Astra cho thấy vai trò của mô hình nền trong robot đang thay đổi

Theo kết quả mà nhóm R​​Pent công bố, GPT-6 Astra đạt 92,63% trên LIBERO-Pro khi được kết hợp với R​​Pent, cao hơn mức 82,4% của cấu hình sử dụng Opus-4.7 trong cùng hệ thống. Ở bài kiểm tra RoboCasa365 Target50, cấu hình R​​Pent/GPT-6 Astra đạt 59,2%, trong khi R​​Pent/GPT-5.5 đạt 57,1%. Điểm đáng chú ý ở đây không đơn giản là GPT-6 Astra đạt điểm cao hơn một mô hình khác. Điều quan trọng hơn là mô hình ngôn ngữ không trực tiếp gánh toàn bộ nhiệm vụ điều khiển robot. R​​Pent phân chia công việc thành nhiều tầng. Agentic Planner sử dụng foundation model để hiểu mục tiêu, Memory để truy xuất kinh nghiệm và Tool Library để lựa chọn năng lực phù hợp. Các Action Primitive sau đó kết nối với VLA, WAM hoặc những kỹ năng được lập trình để thực hiện thao tác. Hệ thống được chia thành bốn lớp chính: - User Layer: giao diện CLI hoặc Web Dashboard để người dùng giao nhiệm vụ và theo dõi quá trình thực hiện. - Intelligence Layer: lập kế hoạch, bộ nhớ và điều phối công cụ. - Interface Layer: chuyển quyết định của AI thành lệnh mà robot hoặc môi trường mô phỏng có thể thực hiện. - Environment Layer: kết nối với robot thật hoặc simulator. R​​Pent hiện hỗ trợ các môi trường như LIBERO-Pro, LIBERO, RoboCasa, RoboTwin và RoboDojo, cùng một số thiết bị như Franka, robot Franka hai tay, YAM và SO101. Kiến trúc này cũng nhằm giải quyết một vấn đề quan trọng của robot: mỗi thiết bị thường có giao diện điều khiển khác nhau. Nếu mỗi robot phải xây dựng một AI agent riêng, việc mở rộng hệ thống sẽ rất khó. R​​Pent thay vào đó tạo ra lớp giao diện chung để tách quyết định của AI khỏi phần cứng thực thi. Về nguyên tắc, một agent có thể sử dụng cùng logic để làm việc với nhiều robot khác nhau nếu chúng cung cấp các giao diện cần thiết. Đây cũng là lý do nhóm phát triển so sánh hướng tiếp cận này với cách các agent trong thế giới số sử dụng công cụ thông qua những giao thức như MCP. Khi bước vào thế giới vật lý, “công cụ” không còn chỉ là trình duyệt, cơ sở dữ liệu hay terminal mà có thể là camera, cánh tay robot, cảm biến hoặc cả một hệ thống mô phỏng. R​​Pent vì thế không cố biến một mô hình AI thành “bộ não toàn năng” điều khiển trực tiếp mọi chuyển động. Thay vào đó, hệ thống chia nhỏ năng lực và để từng thành phần đảm nhiệm phần việc phù hợp. Nếu hướng đi này tiếp tục phát triển, sự thay đổi quan trọng của robot có thể không chỉ đến từ việc VLA ngày càng giỏi hơn, mà còn từ cách các mô hình nền, mô hình chuyên biệt, bộ nhớ và phần cứng được kết nối thành một agent có khả năng học hỏi và tái sử dụng kinh nghiệm. Từ Codex và Claude Code trong thế giới số đến R​​Pent trong thế giới vật lý, mô hình agent đang dần chuyển từ việc gọi công cụ kỹ thuật số sang gọi và điều khiển năng lực vật lý.
GPT-6 Astra
Cộng đồng: