
HPE ProLiant Gen13: Thế hệ máy chủ mới tối ưu cho Agentic AI và trung tâm dữ liệu mật độ cao
HPE ra mắt bốn máy chủ ProLiant Gen13 sử dụng AMD EPYC thế hệ 6, tăng mật độ CPU, hỗ trợ GPU, PCIe Gen6 và nâng cấp bảo mật cho Agentic AI.
Giga Computing trình diễn NVIDIA Vera Rubin NVL72 tại OCP Summit 2026, tích hợp 72 GPU Rubin, 36 CPU Vera và 20,7 TB bộ nhớ HBM4 cho AI quy mô lớn.
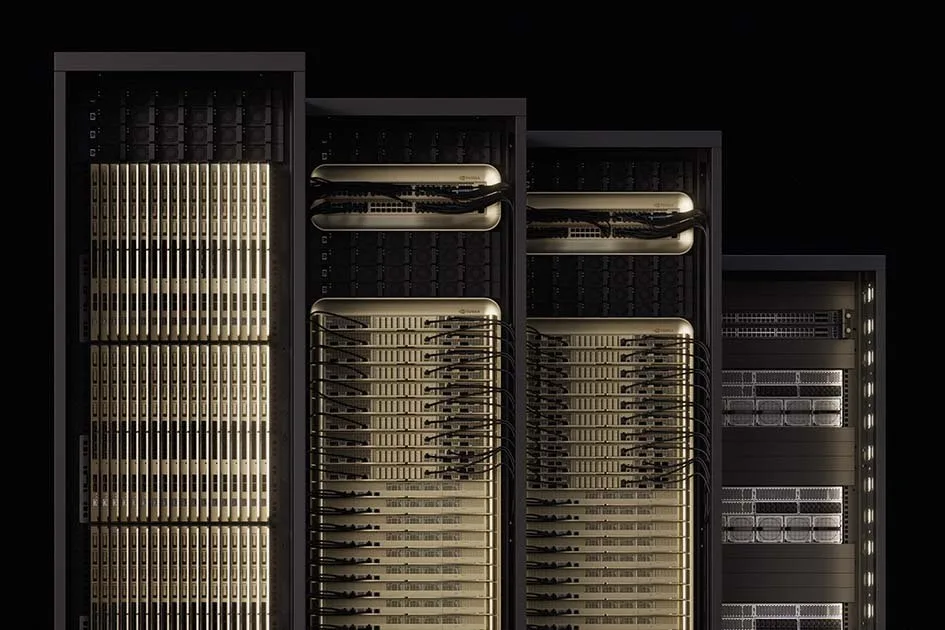
Tại OCP Global Summit 2026 diễn ra từ ngày 12 đến 15/10 ở San Jose, California, Giga Computing — đơn vị chuyên về hạ tầng máy tính thuộc GIGABYTE — đã trình diễn hệ thống NVIDIA Vera Rubin NVL72 tại gian hàng A39. Đây là một trong những điểm nhấn của danh mục hạ tầng AI mà hãng mang đến sự kiện, bên cạnh hệ thống NVIDIA Vera CPU, Groq 3 LPX và các giải pháp máy chủ theo tiêu chuẩn Open Compute Project (OCP). Theo thông cáo của Giga Computing ngày 12/10, hệ thống Vera Rubin NVL72 được giới thiệu trong cấu hình rack hoàn chỉnh, hướng đến những trung tâm dữ liệu cần triển khai AI ở quy mô lớn. Thay vì tập trung vào một máy chủ đơn lẻ, nền tảng này tích hợp bộ xử lý, GPU, kết nối tốc độ cao và các thành phần mạng thành một hệ thống tính toán thống nhất. Đáng chú ý, Vera Rubin NVL72 kết hợp 72 GPU NVIDIA Rubin và 36 CPU NVIDIA Vera, cùng mạng kết nối NVLink thế hệ thứ 6. Hệ thống có tổng dung lượng bộ nhớ HBM4 được công bố ở mức 20,7 TB, tạo nền tảng để xử lý các mô hình ngôn ngữ có quy mô lên đến nghìn tỷ tham số và cửa sổ ngữ cảnh lên đến một triệu token. Việc GIGABYTE trình diễn hệ thống này cũng phản ánh xu hướng chuyển dịch trong thị trường máy chủ AI: các nhà sản xuất không chỉ cung cấp phần cứng riêng lẻ mà ngày càng tham gia sâu vào thiết kế, tích hợp, kiểm thử và triển khai toàn bộ hệ thống rack. Đây là yếu tố quan trọng khi doanh nghiệp cần mở rộng hạ tầng AI nhưng vẫn phải kiểm soát hiệu năng, điện năng, làm mát và độ phức tạp trong vận hành.
Điểm khác biệt của Vera Rubin NVL72 nằm ở cách NVIDIA tổ chức tài nguyên tính toán. Thay vì xem từng GPU là một thiết bị độc lập, hệ thống kết nối 72 GPU Rubin trong cùng một rack thông qua NVLink thế hệ thứ 6, kết hợp với 36 CPU Vera và các thành phần mạng chuyên dụng. Theo thông số NVIDIA công bố, mỗi GPU Rubin được trang bị 288 GB HBM4. Tổng dung lượng bộ nhớ HBM4 của 72 GPU đạt khoảng 20,7 TB, với băng thông bộ nhớ tổng hợp được TechTimes dẫn ở mức khoảng 1,4 petabyte/giây. Đây là các thông số ở cấp độ toàn hệ thống; băng thông tổng hợp không đồng nghĩa với việc một GPU đơn lẻ có thể truy cập toàn bộ dung lượng bộ nhớ ở cùng tốc độ. Cấu hình này hướng đến những mô hình AI có quy mô lớn, đặc biệt là mô hình ngôn ngữ lớn và kiến trúc Mixture of Experts (MoE). Với những mô hình có hàng trăm tỷ đến hàng nghìn tỷ tham số, dung lượng bộ nhớ và khả năng trao đổi dữ liệu giữa các bộ tăng tốc có ảnh hưởng lớn đến cách phân chia mô hình, xử lý ngữ cảnh và duy trì thông lượng suy luận. NVIDIA công bố Vera Rubin NVL72 có hiệu năng suy luận tối đa 3,6 exaFLOPS ở độ chính xác NVFP4. Đây là mức hiệu năng lý thuyết theo định dạng số được chỉ định, không phải kết quả đảm bảo cho mọi mô hình hoặc ứng dụng thực tế. Một rack tích hợp nhiều thành phần cũng đặt ra yêu cầu cao về thiết kế hệ thống. CPU cần điều phối tiến trình và dữ liệu, GPU đảm nhiệm các phép tính AI tăng tốc, trong khi mạng nội bộ phải duy trì trao đổi dữ liệu ở tốc độ cao. Các thành phần này cần hoạt động đồng bộ để hạn chế tình trạng một bộ phận phải chờ tài nguyên từ bộ phận khác.
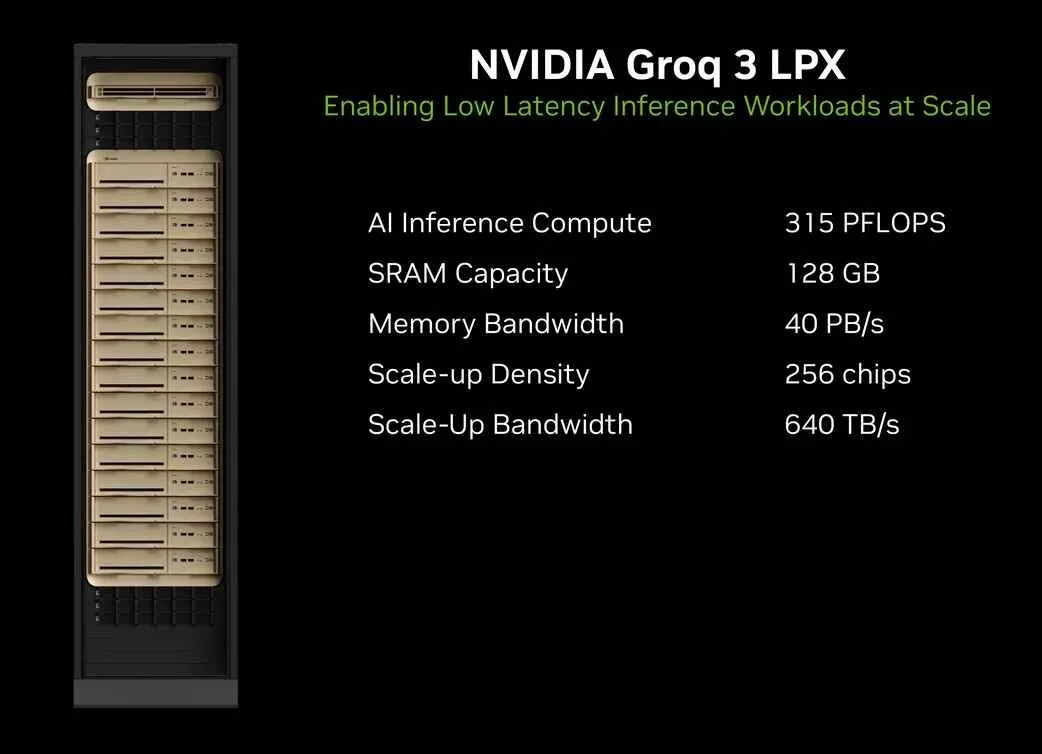
Bên cạnh Vera Rubin NVL72, Giga Computing còn giới thiệu hệ thống NVIDIA Groq 3 LPX, hướng đến một vấn đề khác trong vận hành mô hình ngôn ngữ lớn: tạo token nhanh và duy trì độ trễ ổn định khi có nhiều yêu cầu đồng thời. Quá trình suy luận của mô hình ngôn ngữ thường gồm hai giai đoạn chính. Prefill xử lý đầu vào ban đầu, trong khi decode tạo ra từng token của câu trả lời. Hai giai đoạn có đặc điểm tính toán khác nhau, vì vậy không phải lúc nào việc tăng số lượng GPU cũng là cách tối ưu nhất để cải thiện tốc độ phản hồi. Groq 3 LPX sử dụng các bộ xử lý LPU được thiết kế cho suy luận độ trễ thấp. Theo thông số NVIDIA công bố, hệ thống có 256 LPU, tổng dung lượng SRAM trên chip 128 GB, băng thông SRAM 40 petabyte/giây và năng lực tính toán suy luận 315 petaflops. Những thông số này phục vụ mục tiêu giảm thời gian chờ dữ liệu và cải thiện tốc độ tạo token trong các workload phù hợp. Khi kết hợp với Vera Rubin NVL72, hệ thống có thể phân chia công việc giữa các nền tảng tính toán. GPU Rubin xử lý những phần việc phù hợp với năng lực tính toán song song của GPU, còn LPX tăng tốc những giai đoạn suy luận nhạy cảm với băng thông bộ nhớ và độ trễ. Việc phân bổ cụ thể phụ thuộc vào kiến trúc mô hình, phần mềm điều phối và cấu hình triển khai. NVIDIA tuyên bố cấu hình Vera Rubin NVL72 kết hợp Groq 3 LPX có thể đạt thông lượng suy luận trên mỗi megawatt cao hơn tới 35 lần so với hệ thống Grace Blackwell NVL72 trong các điều kiện so sánh do hãng đưa ra. Đây là số liệu do nhà sản xuất công bố, không nên diễn giải thành mức tăng tốc 35 lần cho mọi mô hình hoặc mọi ứng dụng AI. Việc đưa hai nền tảng lên cùng một hệ thống hạ tầng cho thấy thị trường đang hướng đến kiến trúc AI không đồng nhất, trong đó mỗi loại bộ xử lý đảm nhận phần việc phù hợp thay vì sử dụng một loại chip cho toàn bộ quy trình.
Một thành phần khác trong danh mục trưng bày của Giga Computing là NVIDIA Vera CPU Rack, hệ thống CPU mật độ cao được thiết kế cho các workload cần nhiều môi trường thực thi đồng thời. Khi AI chuyển sang mô hình Agentic AI, hệ thống không chỉ tạo nội dung mà còn có thể thực hiện chuỗi hành động như gọi công cụ, chạy mã, truy xuất dữ liệu, đánh giá kết quả và tiếp tục xử lý theo mục tiêu. Những tác vụ này tạo ra nhu cầu lớn về tài nguyên CPU, đặc biệt khi nhiều agent hoạt động đồng thời. Theo NVIDIA, một rack Vera CPU có thể tích hợp tối đa 256 CPU Vera, hỗ trợ hơn 22.500 môi trường thực thi CPU đồng thời. Hệ thống được thiết kế để chạy các tác vụ điều phối, thực thi mã trong môi trường cô lập, đánh giá kết quả và hỗ trợ quy trình reinforcement learning. Đây là lớp hạ tầng bổ sung cho hệ thống GPU, chứ không phải thiết bị thay thế trực tiếp GPU trong việc huấn luyện hoặc suy luận các mô hình lớn. CPU Vera đảm nhận những công việc phù hợp với xử lý luồng điều khiển và các tiến trình có tính chất tổng quát, qua đó giúp giải phóng tài nguyên GPU cho những phép tính tăng tốc chuyên biệt. Vera CPU Rack được xây dựng trên kiến trúc NVIDIA MGX, tích hợp mạng NVIDIA Spectrum-X Ethernet và thiết kế làm mát bằng chất lỏng. Khi vận hành cùng Vera Rubin NVL72 và Groq 3 LPX, hệ thống có thể trở thành một phần của hạ tầng AI quy mô lớn, trong đó tính toán GPU, suy luận độ trễ thấp và điều phối agent được phân chia thành các lớp riêng biệt. Sự phân chia này ngày càng quan trọng khi doanh nghiệp triển khai AI để xử lý các quy trình nhiều bước. Hiệu năng tổng thể không chỉ phụ thuộc vào tốc độ tạo token mà còn vào thời gian thực hiện công cụ, xử lý dữ liệu và điều phối giữa các tiến trình.
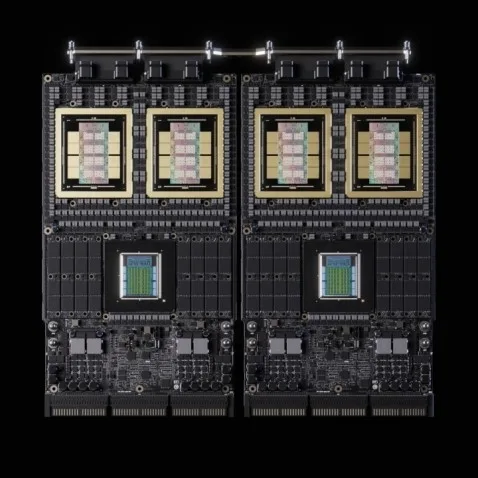
Ngoài các nền tảng NVIDIA, Giga Computing còn giới thiệu hệ thống rack theo tiêu chuẩn OCP Open Rack Version 3 (ORV3), hỗ trợ cấu hình máy chủ dùng CPU AMD EPYC và Intel Xeon, cùng các node tính toán, lưu trữ flash tốc độ cao và thành phần quản lý. Điểm đáng chú ý của kiến trúc này là khả năng triển khai hạ tầng theo hướng tiêu chuẩn hóa. Thay vì phụ thuộc hoàn toàn vào một cấu hình rack khép kín, doanh nghiệp có thể lựa chọn các thành phần tương thích để xây dựng hệ thống phù hợp với nhu cầu tính toán, lưu trữ và mạng. Tuy nhiên, mức độ linh hoạt thực tế vẫn phụ thuộc vào khả năng tương thích của từng nền tảng và thiết kế triển khai. Giga Computing cũng giới thiệu dòng GIGABYTE TO46, hướng đến các cấu hình có bo mạch hỗ trợ tối đa tám GPU, bao gồm hệ thống dựa trên NVIDIA HGX B300. Những máy chủ mật độ cao này cần giải quyết đồng thời bài toán cấp điện, tản nhiệt và duy trì độ ổn định khi vận hành liên tục. Trong thông cáo tại OCP Summit, Giga Computing cho biết danh mục máy chủ OCP của hãng sử dụng làm mát trực tiếp bằng chất lỏng (Direct Liquid Cooling – DLC). Phương pháp này đưa chất lỏng đến các bộ phận cần tản nhiệt thông qua những tấm trao đổi nhiệt, giúp xử lý tải nhiệt cao mà không phụ thuộc hoàn toàn vào luồng khí bên trong rack. Một điểm đáng chú ý khác là bộ phân phối điện 800V do đối tác TaiSol Electronics trưng bày. Khi công suất tiêu thụ của rack AI tăng cao, phân phối điện ở điện áp cao hơn có thể giảm dòng điện cần thiết cho cùng mức công suất, từ đó hạn chế tổn hao điện trở trên dây dẫn. Tuy nhiên, việc triển khai 800V đòi hỏi thiết kế tương thích cho hệ thống cấp nguồn, bảo vệ điện và các thiết bị chuyển đổi điện áp. Nhìn tổng thể, sự xuất hiện đồng thời của Vera Rubin NVL72, Groq 3 LPX, Vera CPU Rack và ORV3 cho thấy Giga Computing đang phát triển danh mục từ máy chủ riêng lẻ sang hạ tầng AI ở cấp độ rack. Trong mô hình này, hiệu năng không chỉ được quyết định bởi GPU hay CPU mà còn bởi khả năng tích hợp mạng, lưu trữ, nguồn điện, làm mát và phần mềm quản lý thành một hệ thống đồng bộ. Đối với các doanh nghiệp đang xây dựng trung tâm dữ liệu AI, đây cũng là lời nhắc rằng việc lựa chọn phần cứng cần đi kèm kế hoạch về mật độ rack, công suất điện, hệ thống làm mát và khả năng mở rộng trong tương lai. Một nền tảng mạnh chỉ phát huy hết giá trị khi hạ tầng xung quanh có thể đáp ứng yêu cầu vận hành của nó.
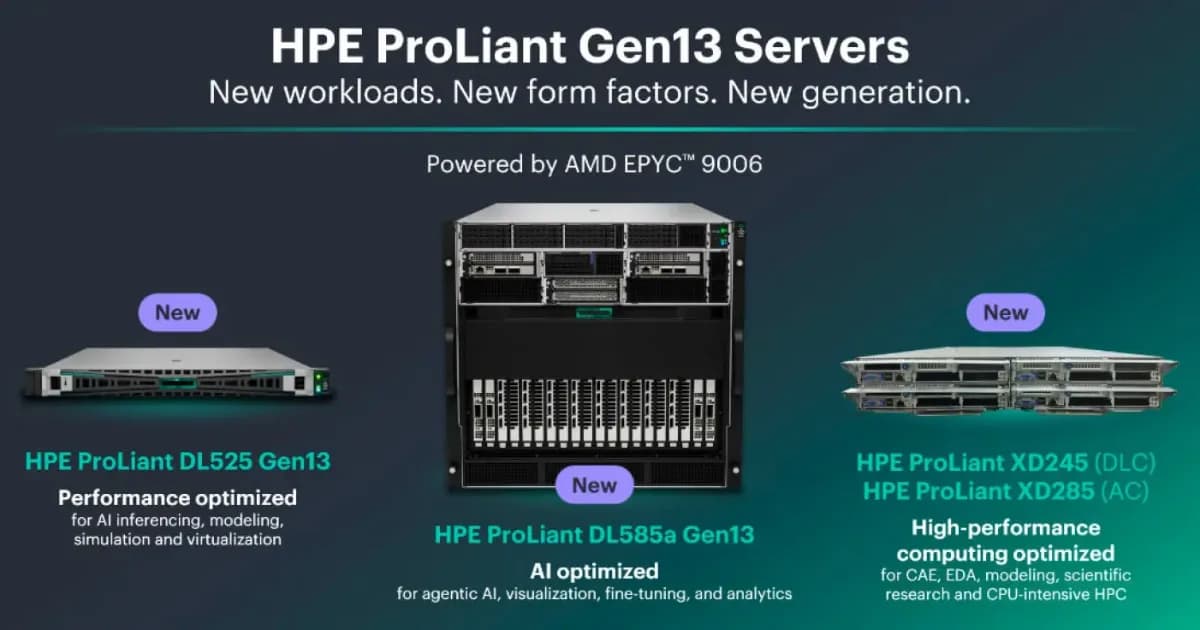
HPE ra mắt bốn máy chủ ProLiant Gen13 sử dụng AMD EPYC thế hệ 6, tăng mật độ CPU, hỗ trợ GPU, PCIe Gen6 và nâng cấp bảo mật cho Agentic AI.
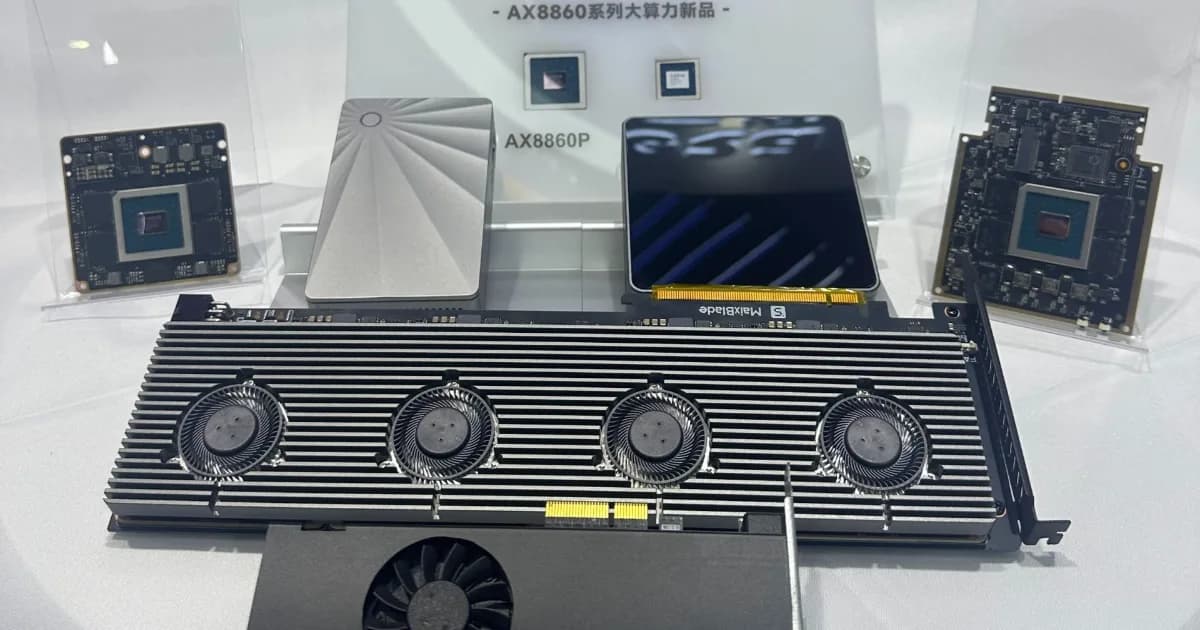
Công ty chip Trung Quốc Axera (爱芯元智) vừa chính thức ra mắt dòng chip AI AX8860 tại Hội chợ Công nghiệp Quốc tế Trung Quốc 2026 (CIIF 2026) ở Thượng Hải vào ngày 13 tháng 10 năm 2026. Chip này được định vị là nền tảng tính toán cho suy luận mô hình ngôn ngữ lớn (LLM) và AI agent ở cạnh biên (edge), với tuyên bố hiệu năng vượt NVIDIA DGX Spark trên một số bài kiểm tra, đồng thời tiêu thụ điện và giá thành thấp hơn đáng kể.
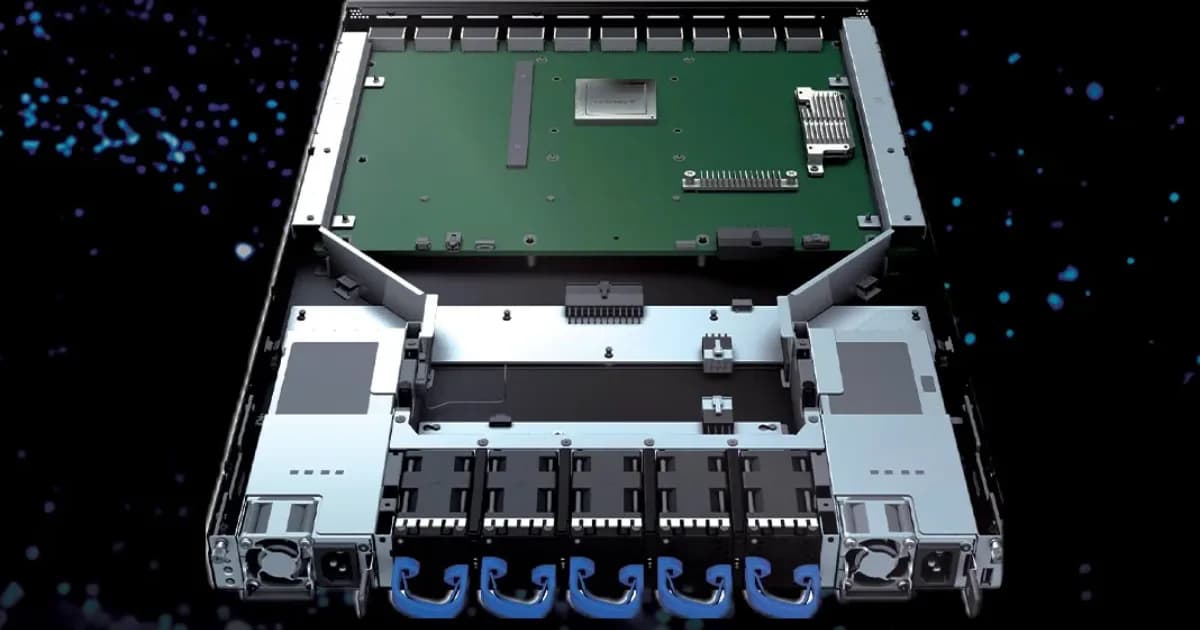
Astera Labs công bố Orion, kiến trúc tham chiếu dạng rack dành cho hạ tầng AI inference, cho phép doanh nghiệp chủ động lựa chọn CPU và GPU từ nhiều nhà cung cấp. Với kết nối PCIe 6.0, thiết kế mô-đun và khả năng mở rộng từ 8 đến 160 bộ tăng tốc trong mỗi pod, Orion hướng đến mục tiêu giảm chi phí triển khai và tối ưu hiệu quả xử lý AI trên mỗi USD đầu tư.
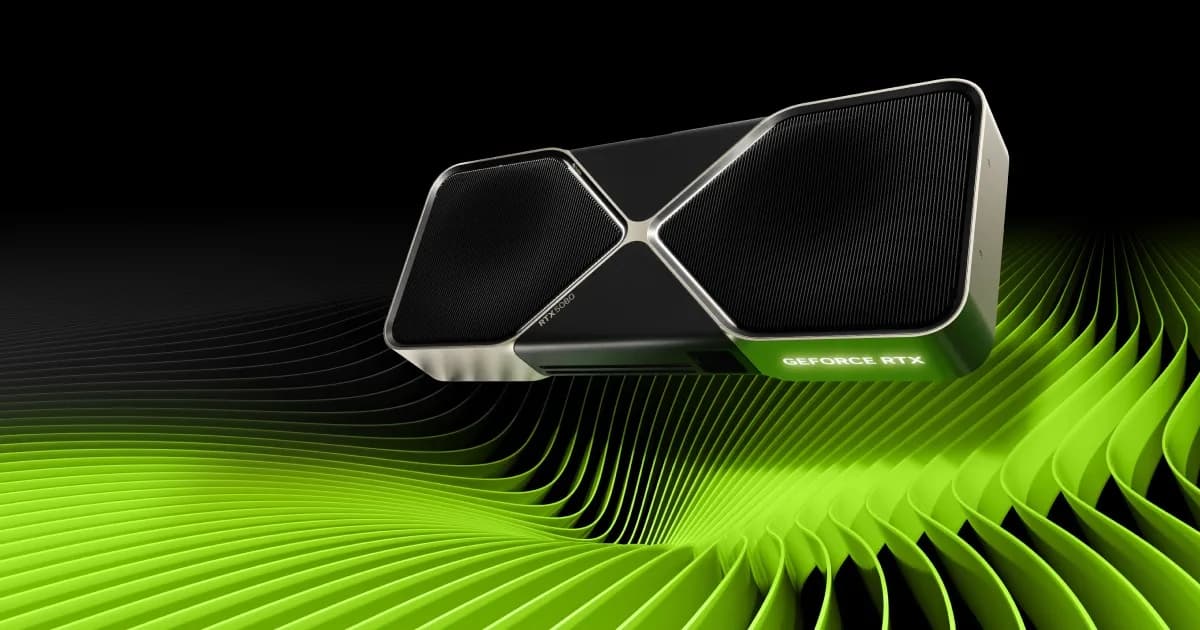
NVIDIA được cho là đang lên kế hoạch phát hành GeForce RTX 5080 với 24GB bộ nhớ GDDR7 trong quý I/2027, thay thế phiên bản 16GB hiện tại. Nếu thông tin từ các nguồn rò rỉ chính xác, đây có thể trở thành mẫu card GeForce cao cấp nhất còn được cung cấp trong bối cảnh nguồn GPU RTX 5090 được cho là đang có sự điều chỉnh. Tuy nhiên, kế hoạch ra mắt và thông số của sản phẩm mới vẫn chưa được NVIDIA xác nhận.
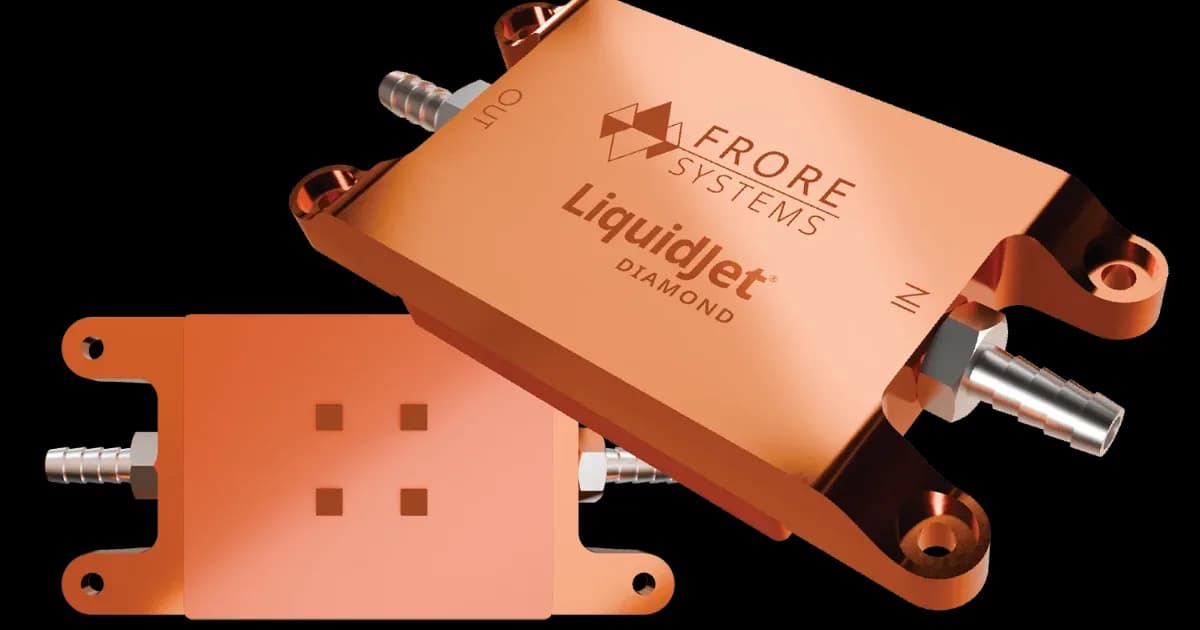
Frore Systems vừa công bố LiquidJet Diamond, giải pháp tản nhiệt chất lỏng trực tiếp sử dụng các tấm kim cương tích hợp để xử lý những điểm nóng có mật độ nhiệt cực cao trên GPU AI thế hệ mới. Theo công bố của hãng, hệ thống có thể hỗ trợ mật độ nhiệt cục bộ lên đến 770 W/cm², giảm nhiệt độ GPU tối đa 22°C và cải thiện hiệu suất tạo token trên mỗi watt điện từ 30% đến 35% so với một số giải pháp coldplate truyền thống. Công nghệ này hướng đến các bộ tăng tốc AI công suất rất lớn, bao gồm NVIDIA Rubin và dòng AMD Instinct MI400, MI500. Frore dự kiến trình diễn giải pháp làm mát cho bộ tăng tốc NVIDIA Rubin công suất 2.300W tại sự kiện OCP Global Summit diễn ra từ ngày 12 đến 16/10/2026. Các con số hiệu năng hiện được công bố bởi nhà sản xuất, vì vậy cần được xem là kết quả theo điều kiện thử nghiệm và mô hình của hãng, chưa phải kết quả kiểm chứng độc lập trên mọi hệ thống thực tế.
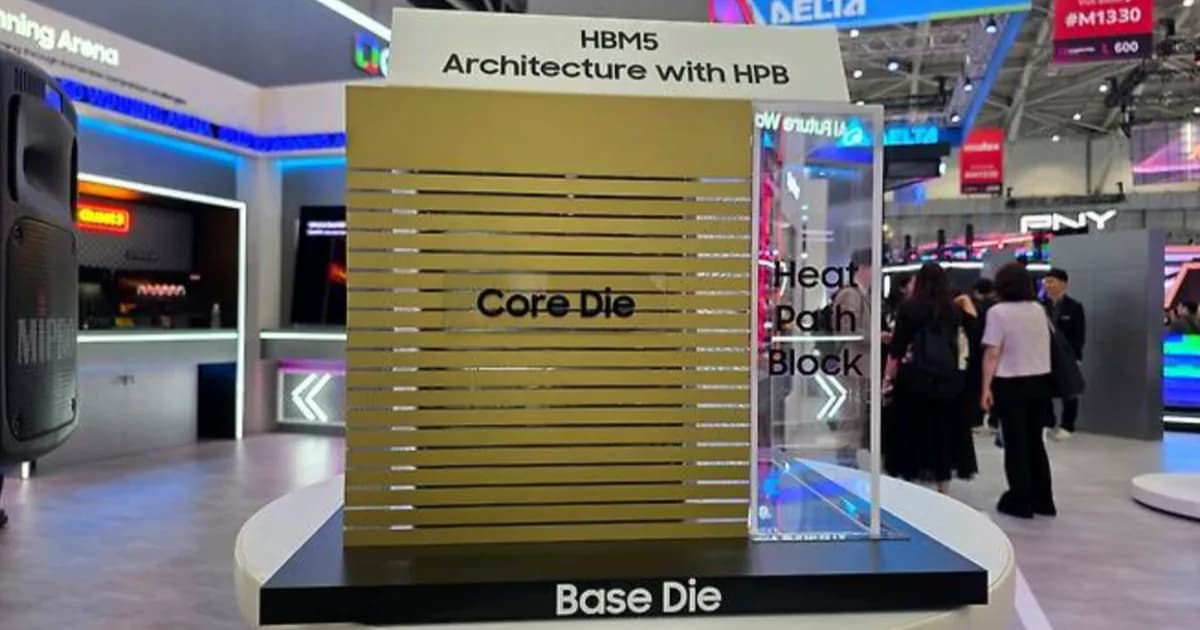
AMD đang tìm cách mở rộng quan hệ chiến lược với Samsung Electronics nhằm đảm bảo nguồn cung bộ nhớ phục vụ các hệ thống AI thế hệ mới. Đổi lại, Samsung được cho là muốn biến quan hệ cung cấp bộ nhớ hiện tại thành cơ hội nhận thêm đơn hàng gia công chip logic. Hai bên đã ký biên bản ghi nhớ về hợp tác bộ nhớ vào tháng 3/2026, đồng thời xác nhận đang thảo luận khả năng hợp tác trong lĩnh vực sản xuất bán dẫn. Tuy nhiên, chưa có thông báo chính thức về việc AMD chuyển các đơn hàng chip tiên tiến từ TSMC sang Samsung.
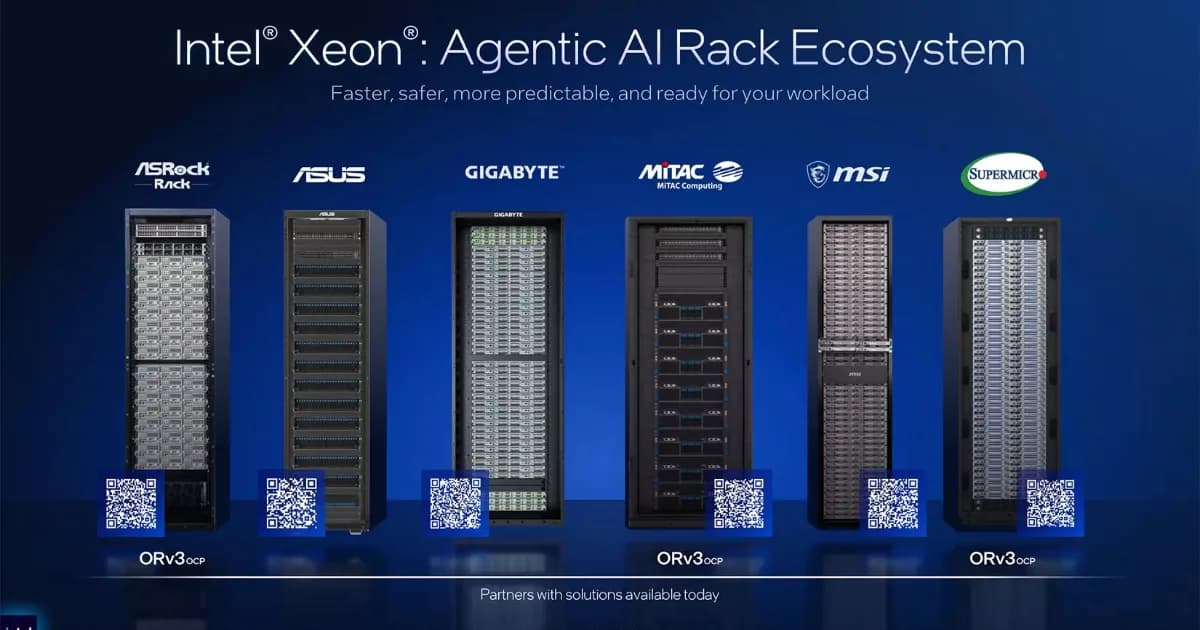
Intel chính thức công bố thêm thông số cho GPU trung tâm dữ liệu D-Series, trước đây có tên mã Crescent Island, tại OCP Global Summit 2026. Được phát triển chuyên biệt cho AI inference, bộ tăng tốc này có thể hỗ trợ tới 480GB bộ nhớ LPDDR5X, băng thông 1,5TB/s và hiệu năng tính toán FP8 tối đa 1,3 petaflops trong mức công suất 350W. Với dung lượng bộ nhớ lớn và thiết kế PCIe làm mát bằng khí, Intel hướng sản phẩm đến các mô hình ngôn ngữ lớn, ngữ cảnh dài và hệ thống AI agent cần xử lý nhiều yêu cầu đồng thời.
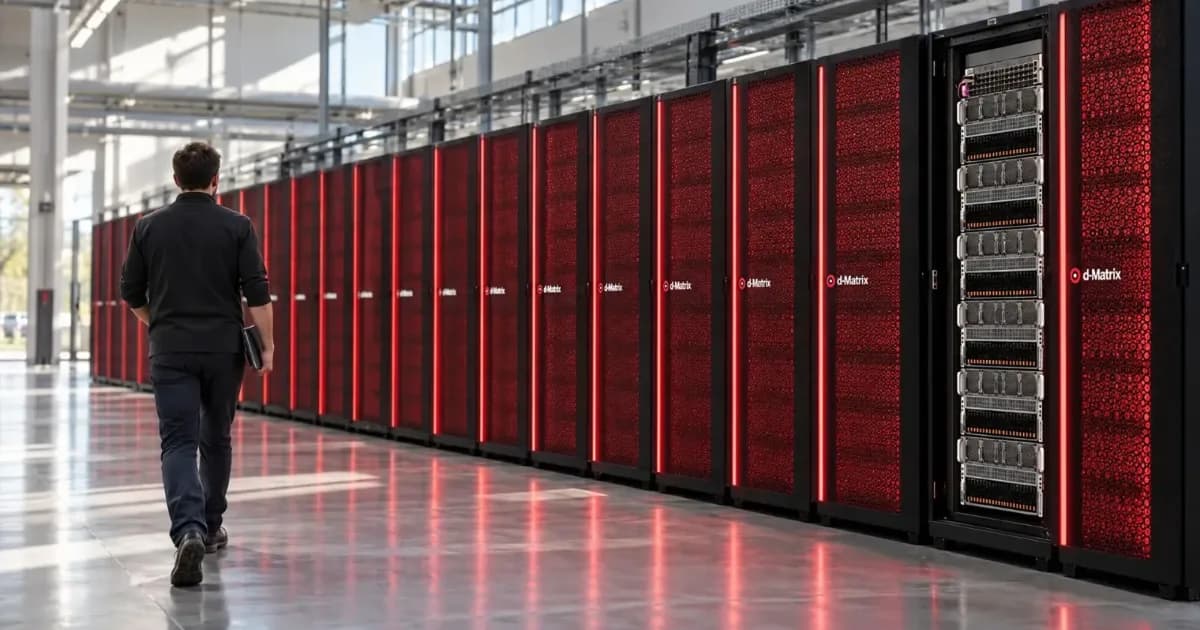
d-Matrix công bố Squadron, nền tảng cụm máy tính AI có thể mở rộng tới 1.024 bộ tăng tốc Corsair XPU, hướng đến các trung tâm dữ liệu cần xử lý suy luận với độ trễ thấp và hiệu quả năng lượng cao. Được phát triển cùng Arista, Broadcom và Supermicro, hệ thống hỗ trợ triển khai nhiều rack làm mát bằng khí, đồng thời có thể kết hợp với GPU NVIDIA để phân chia các công đoạn xử lý AI theo kiến trúc phần cứng phù hợp.