Không có thông báo nào

d-Matrix ra mắt Squadron: Cụm máy chủ AI hỗ trợ 1.024 XPU, tối ưu suy luận tốc độ cao

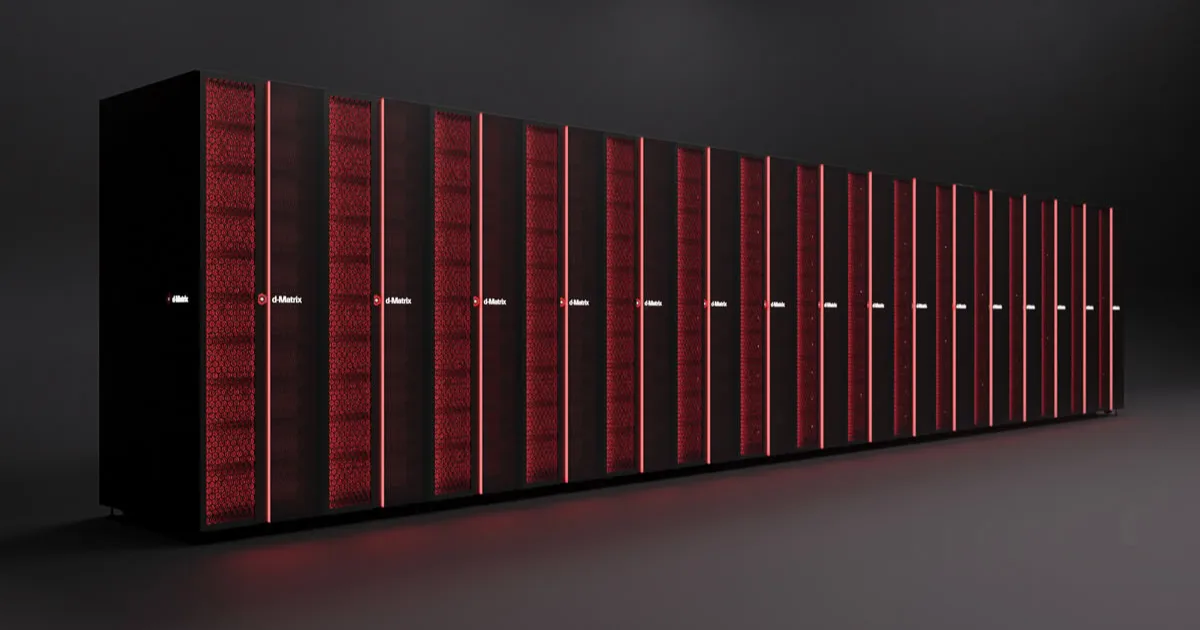
d-Matrix công bố Squadron, nền tảng cụm máy tính AI có thể mở rộng tới 1.024 bộ tăng tốc Corsair XPU, hướng đến các trung tâm dữ liệu cần xử lý suy luận với độ trễ thấp và hiệu quả năng lượng cao. Được phát triển cùng Arista, Broadcom và Supermicro, hệ thống hỗ trợ triển khai nhiều rack làm mát bằng khí, đồng thời có thể kết hợp với GPU NVIDIA để phân chia các công đoạn xử lý AI theo kiến trúc phần cứng phù hợp.

Squadron mở rộng từ máy chủ Corsair lên cụm AI quy mô megawatt

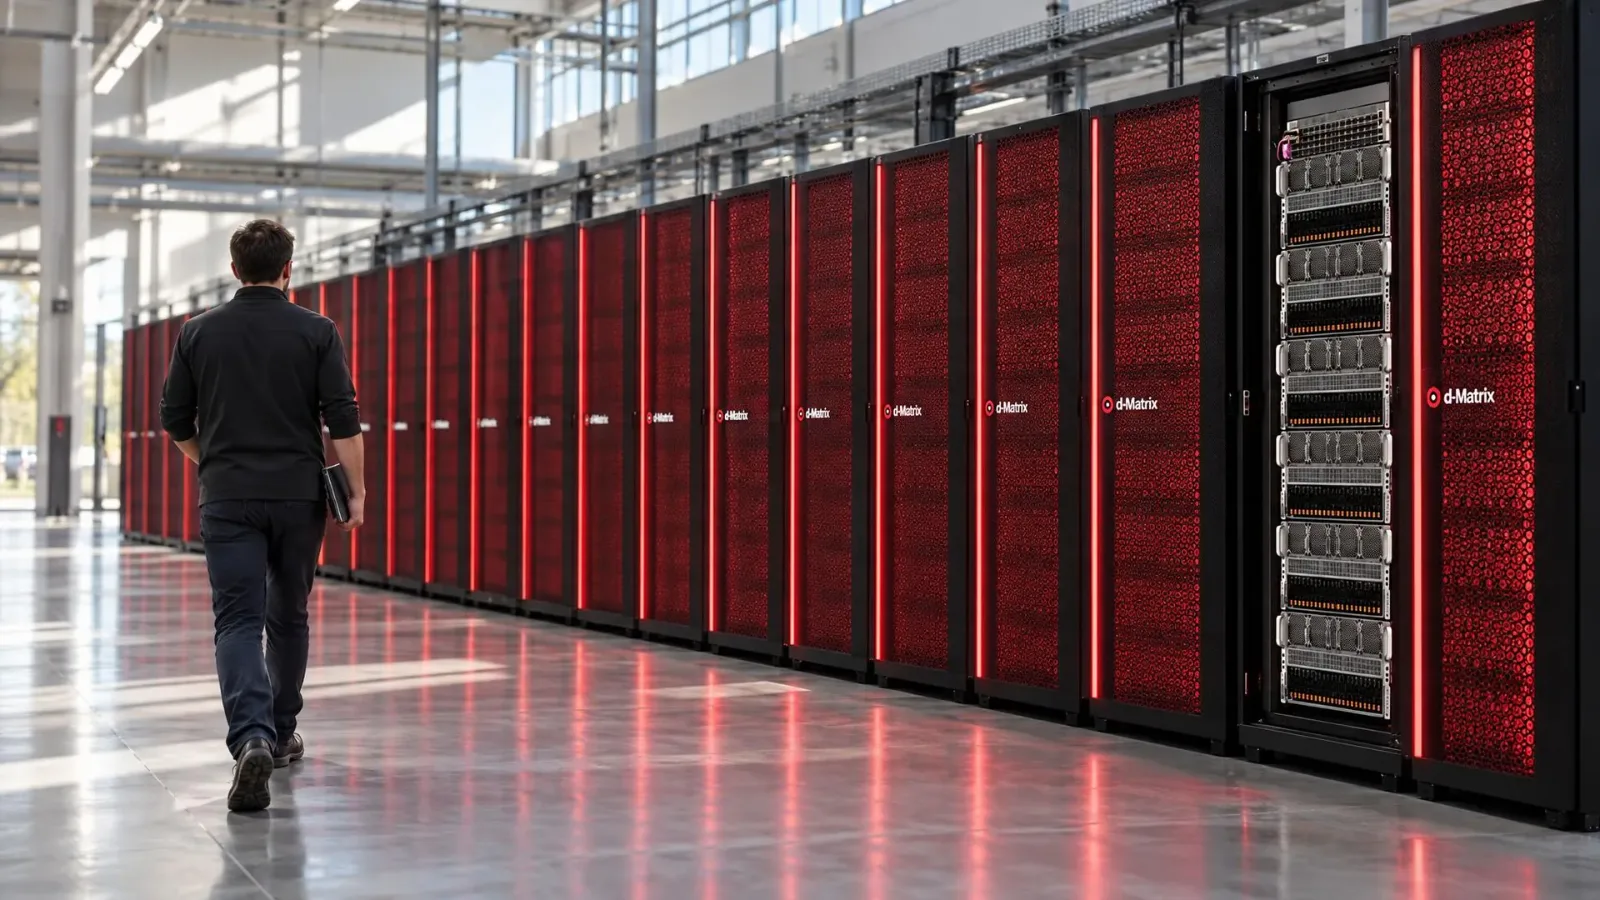
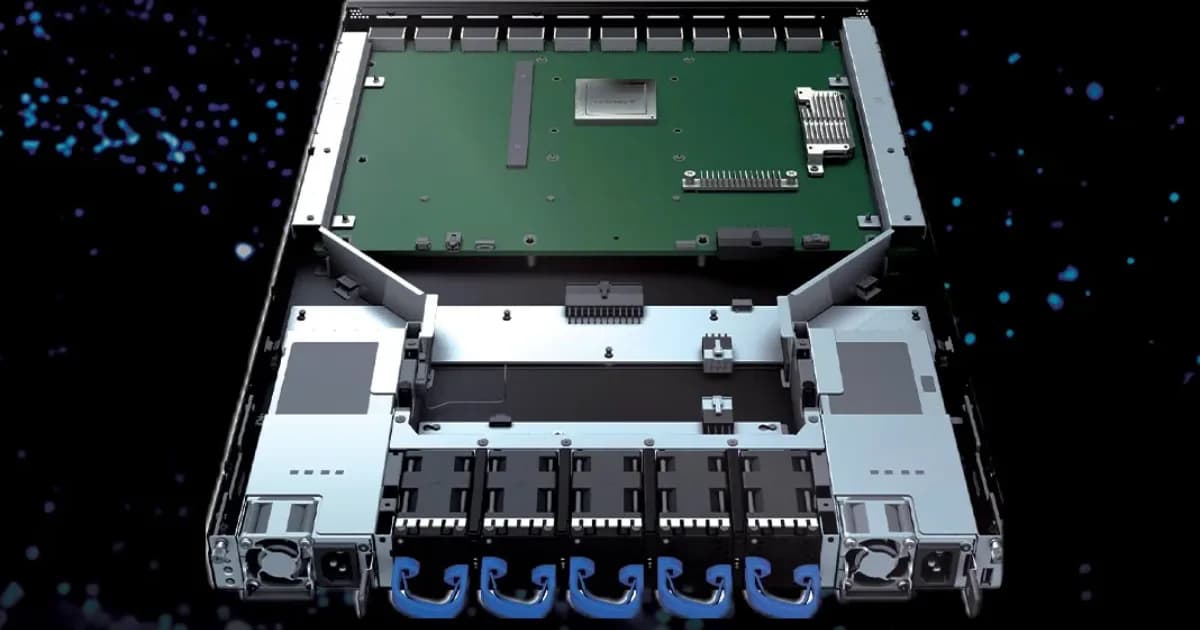
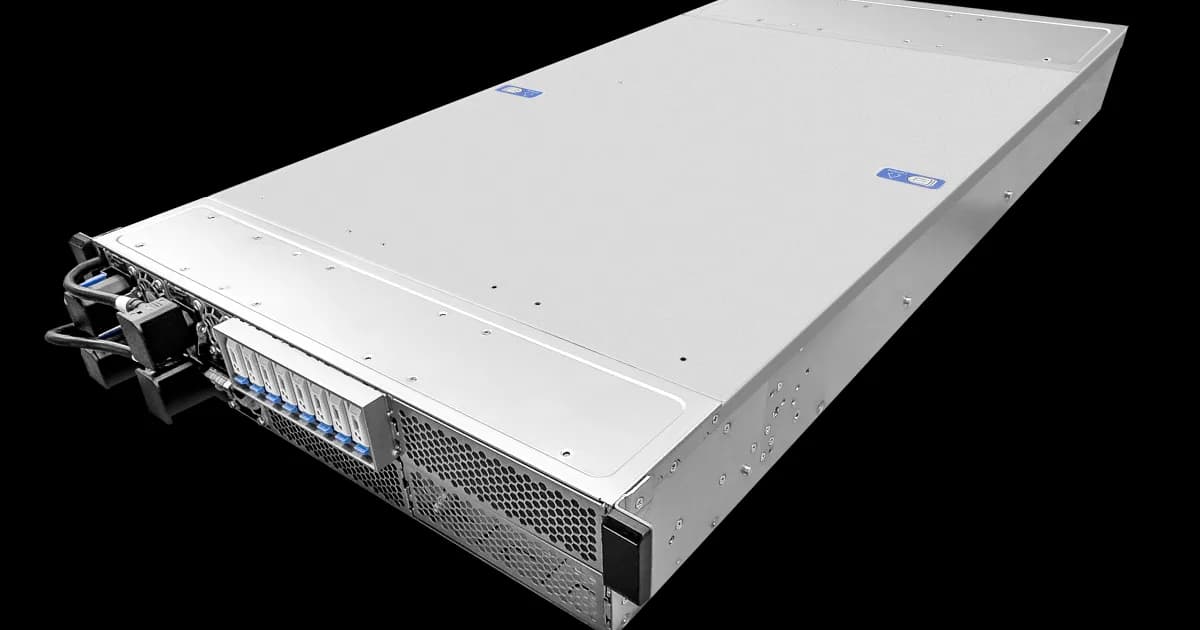
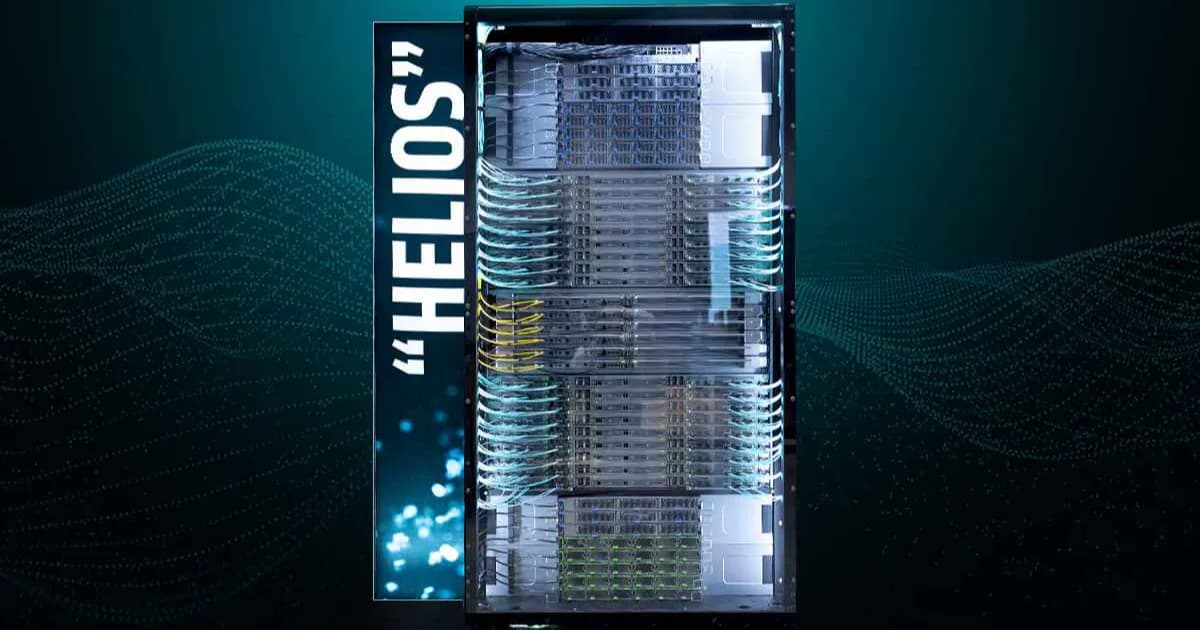
Ngày 12/10/2026, tại OCP Global Summit, d-Matrix công bố Squadron, nền tảng hạ tầng suy luận AI được thiết kế để mở rộng từ một máy chủ Corsair thành cụm nhiều rack trong trung tâm dữ liệu. Theo công ty, cấu hình lớn nhất có thể kết nối tối đa 16 rack SquadRack, tương ứng 1.024 bộ tăng tốc Corsair XPU. Mỗi SquadRack là một rack tích hợp tám máy chủ Corsair. Các rack được kết nối thông qua JetStream NIC, bộ điều hợp mạng do d-Matrix phát triển cho giao tiếp giữa các thành phần tính toán. Phần mềm Aviator hỗ trợ triển khai và tối ưu ứng dụng trên nền tảng Corsair. Hệ thống được phát triển cùng Arista, Broadcom và Supermicro nhằm kết hợp năng lực xử lý của d-Matrix với hạ tầng mạng và máy chủ phục vụ triển khai thực tế. Theo công bố của hãng, Squadron đã được triển khai tại trung tâm dữ liệu của d-Matrix ở bang Arizona để phục vụ nghiên cứu và phát triển, đồng thời bắt đầu giao hàng cho nhóm khách hàng ưu tiên. Các thành phần Corsair server và SquadRack hiện được công ty công bố là đã sẵn sàng cung cấp rộng rãi. Tuy nhiên, điều này không có nghĩa mọi cấu hình Squadron đều được giao ngay cho tất cả khách hàng: thông cáo vẫn đề cập việc triển khai hệ thống cho một số khách hàng được lựa chọn trước. Một điểm đáng chú ý là Squadron sử dụng thiết kế làm mát bằng khí và các tiêu chuẩn hạ tầng phổ biến. Theo d-Matrix, cách tiếp cận này giúp khách hàng tích hợp hệ thống vào trung tâm dữ liệu hiện có mà không bắt buộc phải xây dựng hạ tầng làm mát bằng chất lỏng riêng. Khả năng triển khai thực tế vẫn phụ thuộc vào mật độ công suất, luồng khí và điều kiện vận hành của từng cơ sở.

Corsair XPU tập trung vào bộ nhớ để tăng tốc suy luận AI

Khác với GPU đa dụng thường được sử dụng cho cả huấn luyện lẫn suy luận, Corsair được d-Matrix phát triển chuyên biệt cho các tác vụ suy luận AI. Kiến trúc của bộ tăng tốc tập trung vào việc đưa dữ liệu và năng lực tính toán đến gần nhau hơn, giảm thời gian chờ khi hệ thống phải liên tục truy xuất trọng số mô hình để tạo token. Trong các mô hình ngôn ngữ lớn, đặc biệt là kiến trúc Mixture of Experts (MoE), không phải mọi tham số đều được kích hoạt ở mỗi bước suy luận. Một phần đáng kể công việc có thể tập trung vào các mạng feed-forward và những expert được lựa chọn. Việc liên tục chuyển trọng số giữa bộ nhớ và đơn vị tính toán có thể trở thành nút thắt về độ trễ, ngay cả khi GPU có năng lực tính toán lớn. Corsair sử dụng kiến trúc tính toán dựa trên SRAM nhằm lưu trữ các phần trọng số được sử dụng thường xuyên ở gần đơn vị xử lý. Theo d-Matrix, thiết kế này hướng đến việc giảm độ trễ truy xuất dữ liệu và cải thiện hiệu quả khi phục vụ những yêu cầu cần phản hồi nhanh, chẳng hạn trợ lý lập trình, AI agent, an ninh mạng và các ứng dụng giao dịch tài chính tần suất cao. Squadron có thể chạy mô hình trên các Corsair XPU mà không cần GPU, hoặc kết hợp Corsair với GPU trong hệ thống tính toán không đồng nhất. Ở phương án thứ hai, mỗi loại bộ xử lý đảm nhận phần công việc phù hợp với kiến trúc của mình thay vì buộc toàn bộ quá trình suy luận chạy trên một loại chip. Cách tiếp cận này không nhằm thay thế GPU trong mọi tác vụ AI. GPU vẫn có thể đảm nhiệm những phần việc cần năng lực xử lý song song và bộ nhớ chuyên dụng, trong khi Corsair được sử dụng cho các công đoạn có thể hưởng lợi từ kiến trúc SRAM và khả năng xử lý độ trễ thấp. Hiệu quả phụ thuộc vào mô hình, cách phân chia tác vụ và chi phí truyền dữ liệu giữa các bộ xử lý.

Kết hợp GPU NVIDIA và Corsair: Công bố thông lượng hơn 20.000 token/giây

Cùng với Squadron, d-Matrix công bố kết quả trình diễn kỹ thuật sử dụng phương pháp Attention-FFN Disaggregation (AFD). Đây là cách phân chia các thành phần của mô hình AI thành những nhóm công việc riêng biệt, sau đó chạy chúng trên loại phần cứng phù hợp. Trong cấu hình được hãng trình bày, GPU NVIDIA đảm nhiệm attention, embedding, KV cache và định tuyến expert, còn Corsair XPU xử lý phần feed-forward network (FFN), bao gồm phép tính trên các expert được kích hoạt. Dữ liệu trung gian được trao đổi giữa GPU và cụm Corsair thông qua hạ tầng kết nối JetStream. Theo d-Matrix, thử nghiệm đạt tốc độ tạo sinh 845 token/giây cho mỗi người dùng. Khi phục vụ đồng thời 64 người dùng, tổng thông lượng được công bố đạt 20.415 token/giây. Đây là kết quả do nhà sản xuất công bố cho cấu hình thử nghiệm cụ thể, không phải mức hiệu năng mặc định của mọi hệ thống Squadron. Kết quả thực tế còn phụ thuộc vào mô hình, độ dài ngữ cảnh, kích thước lô xử lý, cấu hình GPU và XPU cũng như cách triển khai phần mềm. Vì vậy, cần có thêm dữ liệu kiểm thử độc lập và điều kiện đo chi tiết để so sánh công bằng với hệ thống chỉ sử dụng GPU. Nếu phương pháp AFD chứng minh được hiệu quả trong nhiều môi trường sản xuất, doanh nghiệp có thể tăng mức sử dụng GPU bằng cách chuyển một số công đoạn có đặc tính bộ nhớ phù hợp sang bộ tăng tốc chuyên biệt. Mục tiêu không chỉ là tăng tổng số token xử lý mà còn cải thiện khả năng phản hồi khi phục vụ nhiều yêu cầu tương tác. Việc Squadron bắt đầu giao hàng cho khách hàng ưu tiên đánh dấu bước chuyển của d-Matrix từ nhà phát triển chip chuyên dụng sang nhà cung cấp hạ tầng suy luận AI ở cấp độ rack. Với khả năng mở rộng nhiều rack, làm mát bằng khí và kết hợp GPU với XPU, nền tảng này hướng đến những trung tâm dữ liệu muốn tối ưu chi phí và độ trễ cho AI inference. Tuy nhiên, mức tiết kiệm năng lượng và chi phí tổng thể cần được đánh giá trên từng khối lượng công việc thực tế trước khi có thể kết luận lợi thế so với các kiến trúc khác.
Cộng đồng: