Không có thông báo nào

Astera Labs ra mắt Orion: Kiến trúc rack AI hỗ trợ tới 160 GPU, không phụ thuộc nhà cung cấp phần cứng

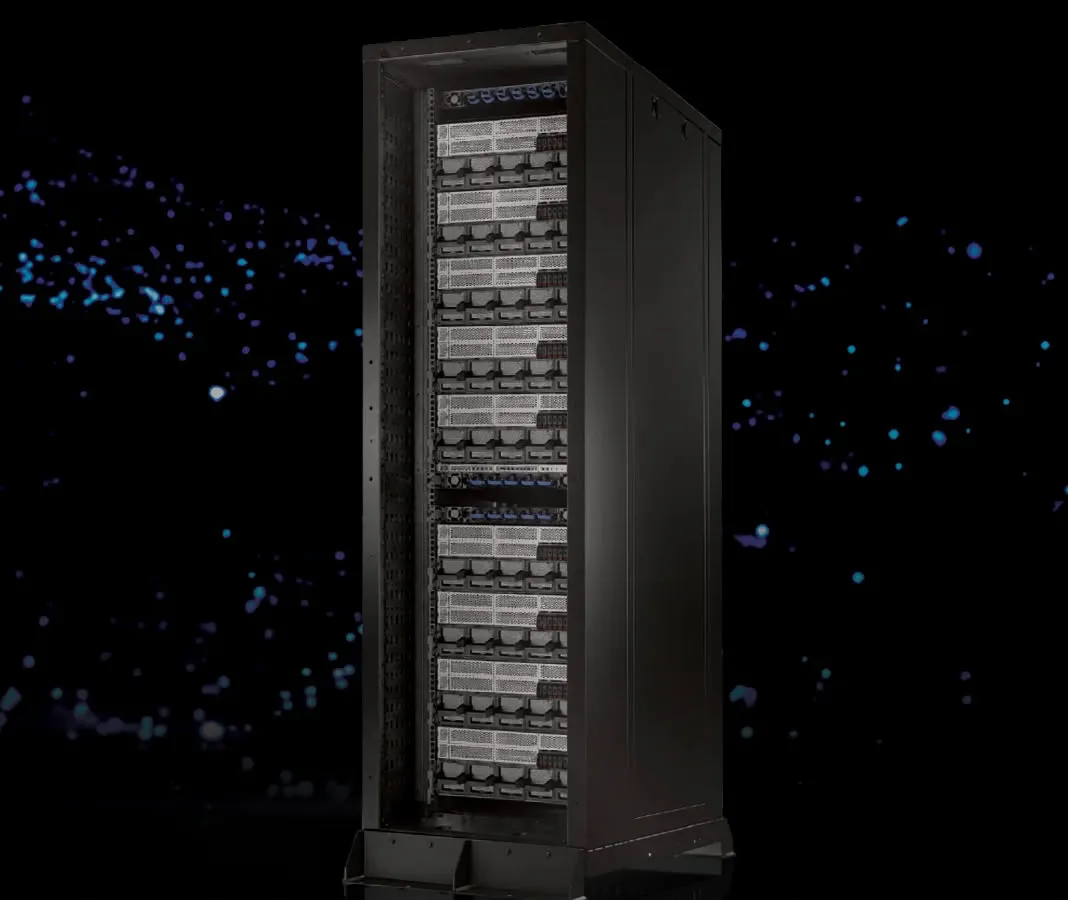
Astera Labs công bố Orion, kiến trúc tham chiếu dạng rack dành cho hạ tầng AI inference, cho phép doanh nghiệp chủ động lựa chọn CPU và GPU từ nhiều nhà cung cấp. Với kết nối PCIe 6.0, thiết kế mô-đun và khả năng mở rộng từ 8 đến 160 bộ tăng tốc trong mỗi pod, Orion hướng đến mục tiêu giảm chi phí triển khai và tối ưu hiệu quả xử lý AI trên mỗi USD đầu tư.

Orion giải quyết bài toán phụ thuộc vào một nền tảng GPU duy nhất

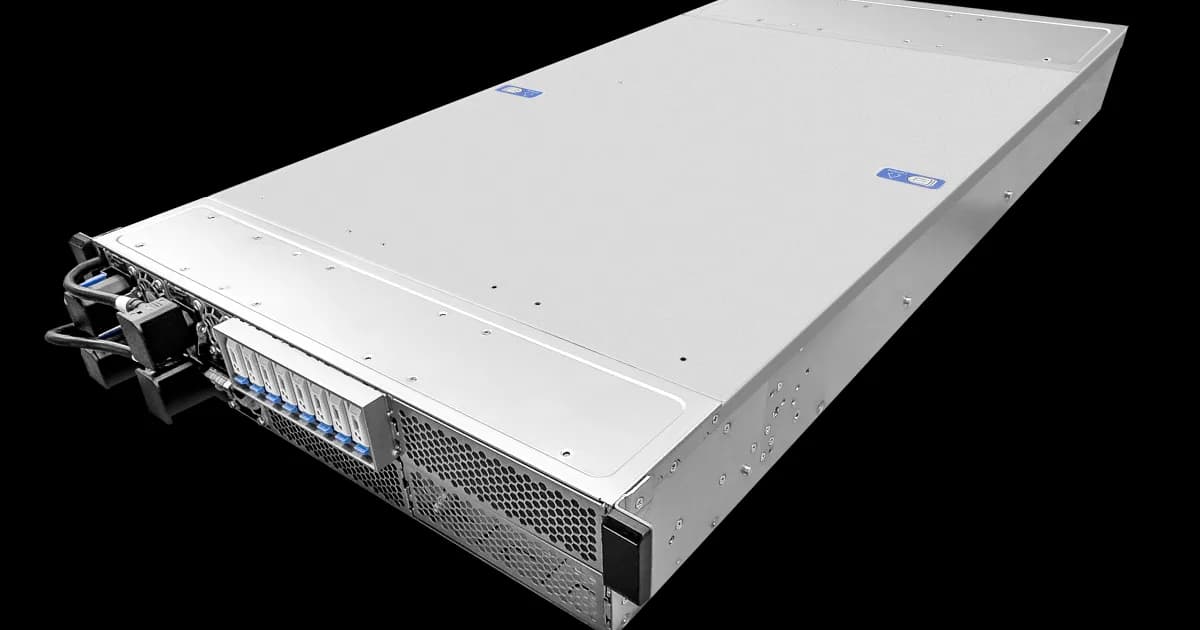
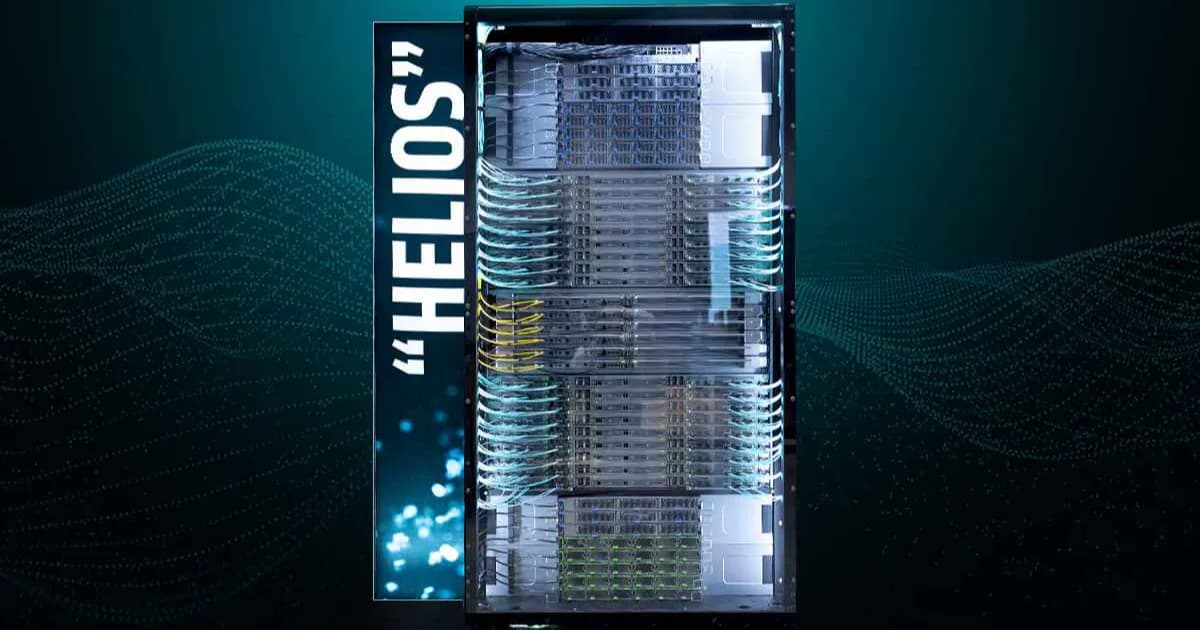
Ngày 12/10/2026, Astera Labs công bố Orion tại sự kiện OCP Global Summit 2026. Đây là kiến trúc tham chiếu hạ tầng AI dạng rack được phát triển để giúp các nhà cung cấp dịch vụ AI trên đám mây và doanh nghiệp mở rộng năng lực suy luận mà không phải gắn toàn bộ hệ thống với một dòng CPU hoặc GPU duy nhất. Trong các trung tâm dữ liệu AI, việc lựa chọn phần cứng không chỉ phụ thuộc vào hiệu năng mà còn liên quan đến giá thành, thời gian giao hàng và khả năng cung ứng. Nếu một hệ thống được thiết kế riêng cho một nền tảng tăng tốc cụ thể, việc chuyển sang phần cứng khác có thể đòi hỏi thay đổi thiết kế, kiểm thử và tích hợp lại toàn bộ hạ tầng. Orion được xây dựng theo hướng compute-agnostic, tức không phụ thuộc vào một nhà cung cấp bộ xử lý duy nhất. Doanh nghiệp có thể lựa chọn CPU và GPU dựa trên khối lượng công việc, ngân sách và nguồn hàng thực tế, sau đó triển khai chúng trên nền tảng kết nối đã được thiết kế và kiểm chứng. Astera Labs cho biết kiến trúc này hỗ trợ mở rộng từ 8 đến 160 GPU hoặc bộ tăng tốc trong mỗi pod. Mục tiêu không đơn thuần là tăng số lượng GPU, mà còn giúp các nhà vận hành AI linh hoạt hơn trong việc phân bổ tài nguyên cho những mô hình và dịch vụ suy luận khác nhau. Điểm đáng chú ý là Orion không phải một mẫu máy chủ cố định do Astera Labs trực tiếp sản xuất. Hãng cung cấp thiết kế tham chiếu cùng các thành phần kết nối và phần mềm quản lý; các đối tác OEM và ODM sẽ đảm nhiệm việc tích hợp, sản xuất và cung cấp hệ thống hoàn chỉnh.

Kết nối PCIe 6.0, mở rộng tới 160 GPU và hỗ trợ bộ nhớ gắn qua fabric

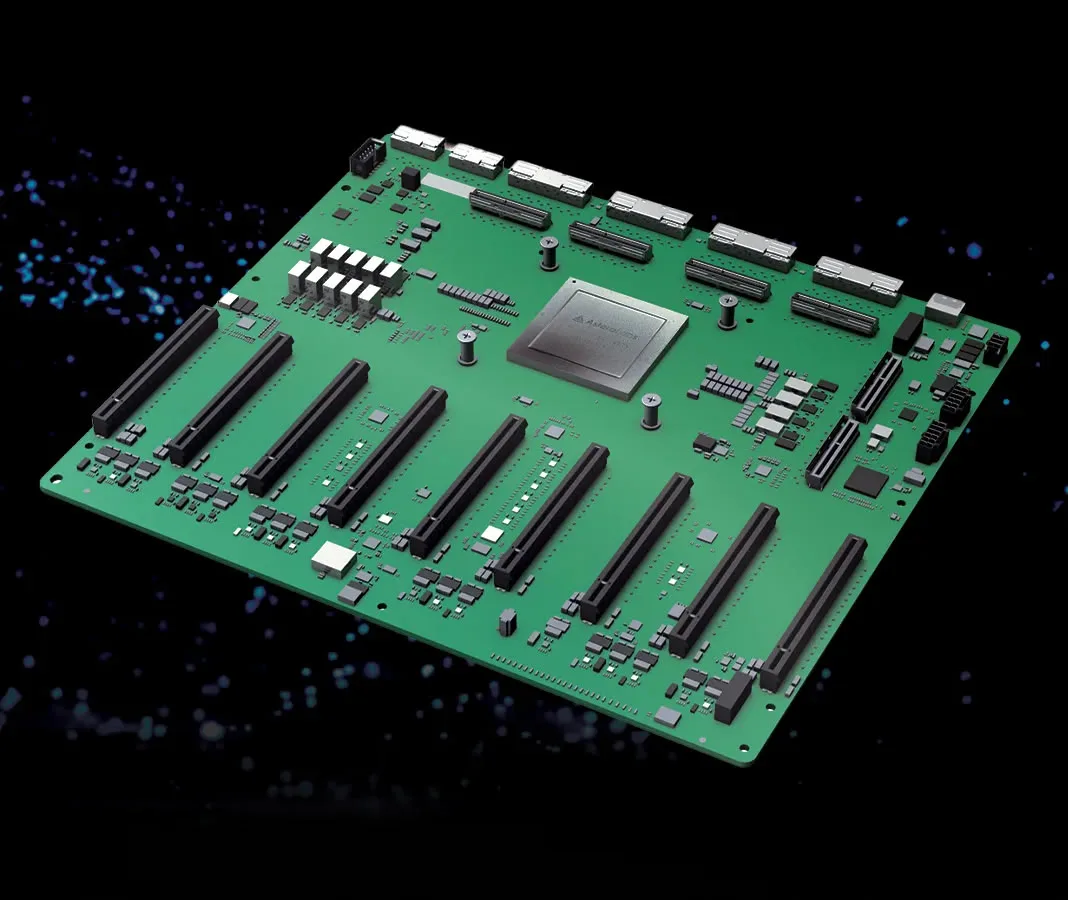
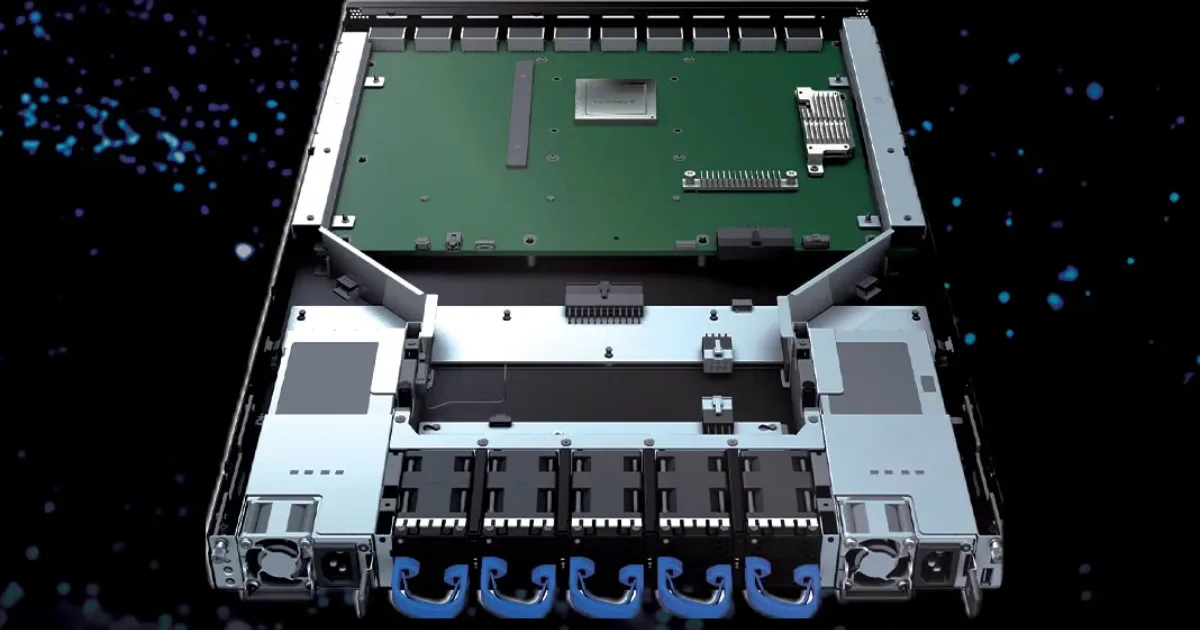
Trung tâm của Orion là kiến trúc kết nối PCIe 6.0 với fabric chuyển mạch 320 lane, được thiết kế để mở rộng giao tiếp giữa các bộ tăng tốc trong hệ thống. Theo Astera Labs, cấu trúc này có thể hỗ trợ tối đa 160 bộ tăng tốc trong mỗi pod, với khả năng truyền dữ liệu độ trễ thấp và mở rộng tài nguyên theo nhu cầu. Ngoài các khay tính toán, Orion còn có những thành phần dành riêng cho fabric kết nối, bảng liên kết và khay bộ nhớ. Thiết kế mô-đun giúp các nhà tích hợp hệ thống tùy chỉnh cấu hình theo từng loại ứng dụng, đồng thời hạn chế việc phải thiết kế lại toàn bộ rack mỗi khi thay đổi phần cứng. Một thành phần đáng chú ý là Orion-MT, khay bộ nhớ có thể mở rộng tài nguyên dữ liệu và bộ nhớ đệm cho các hệ thống AI. Đối với những mô hình ngôn ngữ lớn, KV cache lưu trữ trạng thái trung gian của quá trình suy luận, đặc biệt khi xử lý hội thoại dài hoặc nhiều yêu cầu đồng thời. Việc đưa thêm tài nguyên bộ nhớ đến gần GPU thông qua fabric có thể giúp giảm áp lực lên bộ nhớ cục bộ của bộ tăng tốc và hỗ trợ mở rộng quy mô phục vụ. Tuy nhiên, bộ nhớ gắn qua fabric không đồng nghĩa với việc toàn bộ dung lượng bổ sung có tốc độ hoặc độ trễ tương đương VRAM tích hợp trên GPU. Hiệu quả thực tế còn phụ thuộc vào cấu hình kết nối, phần mềm quản lý bộ nhớ và cách ứng dụng khai thác tài nguyên. Bên cạnh phần cứng, Astera Labs tích hợp bộ phần mềm COSMOS Rack Manager và COSMOS Fabric Manager để quản lý thiết bị, giám sát tình trạng kết nối, thu thập dữ liệu vận hành, chẩn đoán lỗi và điều phối fabric. Những công cụ này hướng đến việc đơn giản hóa quản trị hệ thống khi số lượng máy chủ và bộ tăng tốc tăng lên.
Hướng đến AI inference tiết kiệm chi phí, dự kiến triển khai từ quý I/2027

Astera Labs định vị Orion cho các hệ thống AI inference quy mô lớn, đặc biệt tại các nhà cung cấp dịch vụ đám mây chuyên biệt và doanh nghiệp muốn tự vận hành hạ tầng AI. Thay vì chỉ tập trung vào hiệu năng tối đa của một hệ thống cao cấp, kiến trúc này hướng đến việc tối ưu số lượng token xử lý trên mỗi USD chi phí đầu tư và vận hành. Cách tiếp cận này phù hợp với thực tế rằng không phải mọi tác vụ suy luận đều cần bộ tăng tốc đắt tiền nhất. Những mô hình có yêu cầu khác nhau về bộ nhớ, thông lượng và độ trễ có thể được phân bổ lên các nền tảng phần cứng phù hợp hơn. Nhờ khả năng thay đổi CPU và GPU linh hoạt, nhà vận hành có thêm lựa chọn để cân bằng giữa hiệu năng, giá thành và nguồn cung. Theo Astera Labs, các thiết kế tham chiếu Orion dự kiến được cung cấp thông qua đối tác OEM và ODM từ quý I/2027. Danh mục bao gồm các thành phần như khay tính toán Orion-CT, khay fabric Orion-FT, khay bộ nhớ Orion-MT, bảng tính toán Orion-CB và bảng liên kết Orion-LB. Các thành phần có thể được sử dụng trong một rack hoàn chỉnh hoặc lựa chọn riêng theo nhu cầu triển khai. Trong dài hạn, Astera Labs dự kiến mở rộng lộ trình Orion sang những chuẩn kết nối mở khác, bao gồm UALink. Điều này có thể giúp hệ thống thích ứng với sự thay đổi của hệ sinh thái bộ tăng tốc AI, dù khả năng tương thích và hiệu năng thực tế vẫn cần được xác nhận trên từng cấu hình cụ thể. Orion cho thấy xu hướng phát triển hạ tầng AI đang dịch chuyển từ những hệ thống khép kín, gắn với một nền tảng duy nhất sang kiến trúc mô-đun có khả năng tùy biến cao hơn. Nếu đạt được mục tiêu về khả năng tương thích và hiệu quả chi phí, thiết kế này có thể mang lại thêm lựa chọn cho doanh nghiệp muốn mở rộng năng lực suy luận mà không phải đầu tư vào một cấu hình phần cứng cố định trong nhiều năm.

Cộng đồng: